搜索到
1
篇与
的结果
-
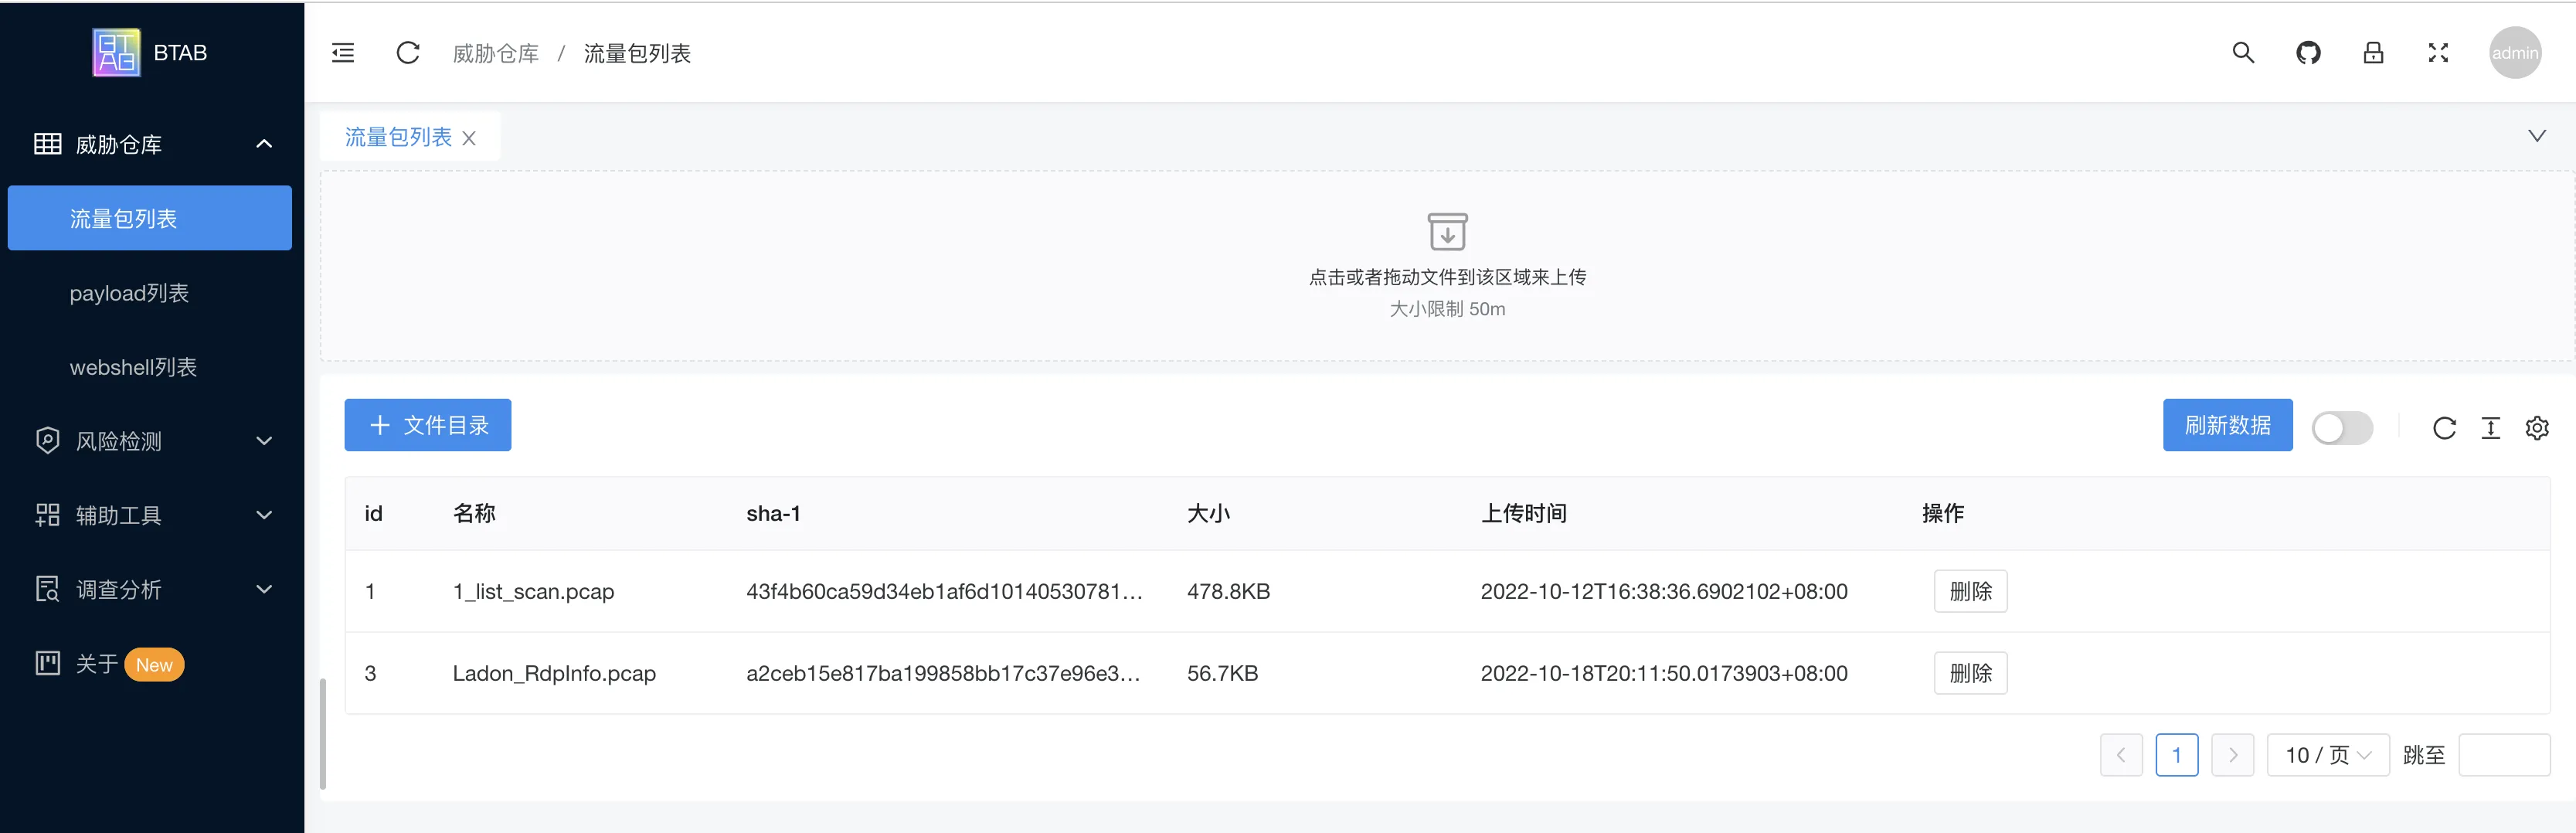
 BTAB蓝队分析箱-技术拆解 BTAB 蓝队分析工具箱干过蓝队研判的人大概都有一套肌肉记忆:拿到一个 pcap,先 tshark -r 拉一遍字段,字段多了加 -Y 过滤,输出的东西想再筛一层就接 jq,jq 表达式写错一个点就得重敲;如果拉到的是 base64 或者序列化数据,还得切到别的工具去解;最后把可疑 payload 复制出来,粘到另一处做检测。一条流程下来命令敲了七八条,中间结果全在终端里滚过去了。想回溯某一步的中间态,只能重新跑一遍。问题不在于工具不够,而在于每一步都是孤岛。tshark 只管拆包,jq 只管切 JSON,检测引擎只管给结论。人就是中间那个传输管道,还得自己维护上下文。BTAB(Blue Team Analysis Box)做的事情很直接:把这些步骤定义成一条可以书写的管道,让上一级的输出自动喂给下一级。作者是 Martin2877(ID:Ali0th),仓库在 https://github.com/Martin2877/btab,Apache-2.0 协议。项目基本盘项目情况仓库地址Github.com/Martin2877/btab作者Martin2877 / Ali0th开源协议Apache License 2.0创建时间2022 年 11 月最后代码提交2024 年 7 月当前 Star96技术栈Go(gin) + Vue(nAIve ui) + Python(gRPC / Jupyter) + Java默认端口8001(gRPC 50051 / WebSocket 5003)仓库标签pcap-analyzer、webshell、http-analysis、detection、chatgpt、golang先把话说明白:这不是一个还在高频迭代的项目。代码停在 2024 年 7 月,Star 数不到三位数,在 GitHub 上属于"小而冷"的那一档。但它值得拆,因为架构设计有想法。DSL 管道 + 统一插件接口 + Jupyter 外挂,这套组合在国产开源蓝队工具里不多见。很多商业流量分析产品的静态查询语句本质是同一套逻辑,只是没开源出来。还有个细节挺有意思——仓库标签里挂着一个 chatgpt。README 的路线图里写着 v0.6.x 要做的事情是:"结合 AI 实现分析,用户复制 payload 到 btab 上,然后拆解并组成问题,然后你黏贴到 GPT 上进行分析"。在 2024 年这个思路算是走得挺前的,现在回头看主要是败在了没有 API 化,靠人肉复制粘贴,效率上不来。四大功能模块启动后访问 http://localhost:8001,左侧菜单就是它的全部能力,分四块。一、威胁仓库三张表:流量包列表、payload 列表、webshell 列表。说白了就是素材池——把待分析的 pcap、可疑 payload、webshell 文件先丢进去存着,后面的检测和查询都从这里取。这个设计挺实用。研判很多时候不是线性的,一个 pcap 里扒出来的 payload 可能过两天才想起来要复检;webshell 样本攒多了也需要一个地方放。有统一的入库动作,比散在桌面某个文件夹里靠名字找强。配图 1:威胁仓库的流量包列表二、风险检测核心模块,六个检测项:菜单说明流量包检测走 pcap 分析引擎,检测结果落库成表HTTP 深度解析请求 / 响应拆解,含 UA 类型识别风险详情检测项的明细视图SQLi 检测注入特征识别XSS 检测跨站脚本特征识别Webshell 检测文件内容特征识别bash 命令检测命令执行行为识别前端表格直接带出 pcap 文件名、来源、检测类型、检测结果、检测时间,一屏看完不用来回切。配图 2:风险检测结果列表三、辅助工具六个工具页:tshark:在页面里直接调 tshark 做字段提取jq:JSON 处理SerializationDumper:Java 反序列化数据解析(原项目是 Java 实现,这里用 go embed 内嵌)BlueTeamTools(ABC_123):内嵌的第三方工具集CyberChef、Regex101:经典工具,内嵌页面配图 3:辅助工具里的 jq内嵌 CyberChef 和 Regex101 这个做法,作者在 README 里也坦白过,是为了"零依赖、开箱可用"。从工程角度看有点偷懒(iframe 嵌外部页面),但对使用者来说确实省了切标签页和记 URL 的力气。四、调查分析整个项目最有前瞻性的一块:用 Jupyter Notebook 做威胁狩猎。查询管道适合固定套路,但真实研判里有很多"没有固定套路"的分析——时序分析、频次统计、聚类、机器学习模型调用。这些用查询语言表达不了,必须上代码。BTAB 的做法是开一个 gRPC 服务(:50051),用 Python 客户端连上去,在 Jupyter 里写脚本调它的引擎。配图 4:Jupyter 中的 log4j 批量检测上图是仓库自带的 S2_Log4j检测_beta.ipynb,遍历 payload 逐个检测 log4j 漏洞,最后打印命中的 payload。这种"脚本驱动批量检测"的用法,比在页面上一个个点效率高得多。装起来:三个依赖和一个端口下载 release,配好 config.yaml 就能启动。完整配置长这样:dbConfig: enabledefault: false sqlite: btab.sqlite logConfig: compress: false max_age: 365 max_backups: 1 max_size: 50 serverConfig: jwt_secret: btab run_mode: release open_browser: true # 启动时自动打开浏览器 engineConfig: webshell_host: "http://localhost:8080" pcapanalyse_host: "http://localhost:5000" bash_host: "http://localhost:8899" grpcConfig: address: :50051 websocketConfig: address: :5003 pcapAnalyseConfig: # tsharkPath: tshark # unix、mac 下使用 tsharkPath: C:\Program Files\Wireshark\tshark.exe # win 下使用三个依赖,按需装:tshark(必装):pcapAnalyseConfig.tsharkPath 必须指向真实的 tshark 路径。Windows 下装 Wireshark 时如果没勾选命令行工具,这个路径根本不存在。Linux / macOS 下直接写 tshark 就行,前提是它在 PATH 里。Java 环境(可选):反序列化解析功能需要。Jupyter 依赖(可选):要用调查分析才装。pip install jupyterlab pip install grpcio-tools启动方式就是双击执行文件,起来后访问 8001 端口。数据库默认用 SQLite,单文件 btab.sqlite,也支持切 MySQL——配置里 mysql 那几行注释掉的部分就是。核心设计一:DSL 管道这是 BTAB 最有想法的地方,值得展开。基本语法它设计了一套自己的查询语言,规则很简单:| 开头的行表示指定一个引擎|: 开头的行表示指定引擎的一个变量: 开头的行表示定义全局变量连续的 | / |: 行组成一节管道最基础的一条,用 pcap 引擎读包:| pcap |: file log4j_test.pcap |: fields ["ip.src", "tcp.srcport", "ip.dst", "tcp.dstport", "text"] |: condition http这三行参数最终等价于这么一条 tshark 命令:tshark -r log4j_test.pcap -Y "http" -T fields -e ip.src -e tcp.srcport -e ip.dst -e tcp.dstport -e text参数都可以省,只写 file 就用默认的 fields 和 condition。省事,但也就意味着拿不到你想要的字段精度——真做分析还是老实把 fields 写全。串联:内联引用真正解决问题的是跨节引用。用 {{R}} 指代上一节的结果,把 pcap 和 jq 串起来:// 拉取数据 | pcap |: file log4j_test.pcap |: fields ["ip.src", "tcp.srcport", "ip.dst", "tcp.dstport", "text"] |: condition http // 针对上一步结果做处理 | jq |: filter .[0] | .text[-1:] |: content {{R}}第一步拿包里符合 http 条件的报文,第二步用 jq 表达式切出最后一个元素,结果自动进下一步。注意 // 是注释,解析器会把以 - 或注释开头的行跳过。多流管道:这套 DSL 的差异点单流管道(上一步输出给下一步)在很多产品里都有,Splunk 的 SPL、Sentinel 的 KQL 本质都是这类思路。BTAB 在这里做了一次升级——从单流升级到多流。意思是管道里的每一步不必只能吃上一步的输出,可以任取前面任意一步的结果,也可以引用自定义的全局变量。: a ' union select concat(md5(2001427499))# : b { "foo": { "bar": { "baz": 123 } } , "boo":"123"} : c { "foo": { "bar": { "baz": "' union select concat(md5(2001427499))#" } } , "boo":"123"} | jq |: filter .foo.bar |: content {{c}} | jq |: filter .foo.bar |: content {{b}} | jq |: filter .baz |: content {{R[0]}} | sqli |: content {{R}}: 定义全局变量,{{c}} 引用变量 c,{{R[0]}} 引用第 1 步的结果,{{R}} 引用上一步。上面这段的执行顺序是:定义三个全局变量 a、b、c用 jq 处理变量 c,取出 { "baz": "' union select concat(md5(2001427499))#" }用 jq 处理变量 b,取出 { "baz": 123 }用 {{R[0]}} 拿第 2 步的结果再取 .baz,得到 ' union select concat(md5(2001427499))#把结果喂给 sqli 引擎,检出注入单流管道只能顺着走一条线,多流管道可以分叉、可以回头取中间态。做复杂载荷构造时差别很明显——你可以在一条查询里同时准备"输入报文"和"应答报文"做交叉比对,不用来回倒腾。配图 5:单流管道模型(每一步的输出即下一步的输入)配图 6:多流管道模型(可任取历史节点结果,形成分叉)完整示例:从 pcap 到 SQLi 判定把三步串成一条流,这是最能说明问题的例子:// 拉取数据 | pcap |: file sqlinjection_9.pcap |: fields ["http.request.uri"] |: condition http // 处理 json 获取 uri | jq |: filter .[].["http.request.uri"][0] |: content {{R}} // 调用 sql 注入检测引擎 | sqli |: content {{R}}拆包 → 提取 URI → 送检测引擎。这就是文章开头说的"把工具串起来"。也可以直接调检测引擎,不带前置管道:| sqli |: content ' union select concat(md5(2001427499))#核心设计二:插件接口管道里能调用的每个东西,在代码里都是一个插件。BTAB 用 Go interface 定了统一规格:type Plugin interface { Init() // 初始化 Set(key string, value interface{}) // 设置插件所需变量 Check() error // 检查设置变量值 Exec() error // 执行此插件 GetState() int // 获取插件任务进度 GetFinalStatus() int // 获取最终结果状态 GetResult() string // 获取输出结果 }七个方法,职责划得很干净:Init 清空状态Set 接收 DSL 里 |: 传进来的参数Check 校验参数,比如文件名为空直接报错,不往下走Exec 真正干活GetState / GetFinalStatus 汇报进度和结果状态,给前端做状态展示GetResult 吐结果,喂给下一节管道注册方式是一个全局 map:var PluginMap = make(map[string]Plugin) func init() { PluginMap["jq"] = &jq.JQ{} PluginMap["SerializationDumper"] = &SerializationDumper.SerializationDumper{} PluginMap["pcap"] = &pcap.Pcap{} }新增一个插件就是实现这七个方法,然后往 map 里补一行。引擎侧启动时会遍历 PluginMap,自动把插件名注册成可用的引擎关键字,不用改 DSL 解析逻辑:func init() { for p := range plugin.PluginMap { PluginEngines = append(PluginEngines, p) } }这个设计的好处是语法和具体能力解耦。加一个"URL 解码"插件,语法层面零改动。README 里写的"理论上能力可以无限扩展",前提就是这个接口稳得住。看一个具体实现,pcap 插件的参数处理:func (plugin *Pcap) Set(key string, value interface{}) { switch key { case "file": plugin.File = value.(string) case "fields": fieldsSource := fmt.Sprintf(`{"fields": %s}`, value.(string)) fields := gjson.Get(fieldsSource, "fields") for _, v := range fields.Array() { plugin.Fields = append(plugin.Fields, v.String()) } case "condition": plugin.Condition = value.(string) } }fields 从 DSL 传进来是一个 JSON 数组字符串,这里借 gjson 解析成 Go 切片再用。所以 DSL 里写 fields ["ip.src", "tcp.srcport"] 合法,写 fields ip.src 就会解析失败——这是上手时容易踩的小坑。校验逻辑也简单直接,缺参数就掐掉:func (plugin *Pcap) Check() error { if plugin.File == "" { return errors.New("参数检查不通过, file 为空") } return nil }核心设计三:Jupyter 调查分析查询语言解决的是"有套路"的分析,"没套路"的要靠脚本。BTAB 通过 gRPC 把引擎能力开放给 Python。仓库 investigation/ 目录下有个 btab.py,是封装好的客户端:import grpc import rpc.btab_pb2 as btab__pb2 import rpc.btab_pb2_grpc as btab_pb2__grpc address = 'localhost:50051' channel = grpc.insecure_channel(address) class Search: def __init__(self) -> None: self.stub = search_pb2__grpc.SearchStub(channel) def Submit(self, content): response = self.stub.Submit(search__pb2.SubmitRequest(content=content)) return response.message class Engines: def __init__(self) -> None: self.stub = engines_pb2__grpc.EnginesStub(channel) def CheckAlive(self): response = self.stub.CheckAlive(engines__pb2.CheckAliveRequest()) return response.message def Run(self, content): response = self.stub.Run(engines__pb2.RunRequest(content=content)) return response.message在 Jupyter 里用起来是这样:import json from btab import BTAB, Engines, Search # 初始化并检查连通性 btabIns = BTAB() if btabIns.Ping().Type == "success": print("连接成功") # 检查所有可用引擎 eg = Engines() if eg.CheckAlive().Type == "success": print("检查完成") # 提交一条查询 search = Search() content = """ // 拉取数据 | pcap |: file log4j_test.pcap |: fields ["ip.src", "tcp.srcport", "ip.dst", "tcp.dstport","text"] |: condition http """ result1 = search.Submit(content) results = json.loads(result1.Result) len(results)注意这里可以在 Python 里直接写 DSL 字符串提交——页面上的查询能力和脚本里的查询能力是同一套,不存在"界面能做、API 不能做"的落差。返回的 Result 是 JSON 字符串,json.loads 之后就是正常的 Python 对象,后面接 pandas、numpy、matplotlib 随你。仓库里给了两个实验性的例子:S7_ssh慢速连接_beta 用 matplotlib 做时序可视化,SX_webshell文件机器学习检测_beta 加载训练好的模型做检测:from machinelearning.WebshellMLChecker import WebshellMLChecker wc = WebshellMLChecker() ret = wc.process(body["request_body"]) print("检测结果:", ret)从"查"到"建模",这条路是通的。虽然都标着 beta,但方向是对的——研判做到深处一定会撞上需要统计和模型的地方,工具能不能承接住这一步,比它内置了多少条规则重要。一个容易被忽略的前提:外部引擎依赖这条得单独拎出来说,因为它直接决定你能不能跑通。看后端的引擎分层:目录内容依赖backend/engine/local/sqli、XSS、http_parseGo 原生实现,离线可用backend/engine/online/pcapanalyse、bashHTTP 调外部服务backend/engine/plugin/jq、pcap、SerializationDumper本地插件问题出在 online 这一类。pcapanalyse 的地址是硬编码默认值加配置覆盖:const Address = "http://127.0.0.1:5000" func NewPA() *PA { address := Address if conf.GlobalConfig.EngineConfig.PcapAnalyseHost != "" { address = conf.GlobalConfig.EngineConfig.PcapAnalyseHost } return &PA{Address: address} }而风险检测里的"流量包检测",调的就是这个引擎。也就是说:只下载 release 包、只装了 tshark,流量包检测这一项是跑不出结果的——它需要一个监听在 localhost:5000 的 pcap 分析服务,而这个 Python 服务在开源仓库里没有。同理bash_host指向localhost:8899,BASh命令的检测同样需要对应外部的服务。作者于 README 中对开源范畴的阐释颇为直白:最多仅能部分进行开源,由于涉及商业方面的问题,企业内部部分核心的检测项不便于开源;但是部分非敏感功能模块能够开源成为独立项目以供学习借鉴。因此对BTAB的合理预期得划分成两个档次:能够直接使用的威胁仓库素材管理,辅助工具tshark,jq,反序列化分析以及 CyberChef,调查分析 Jupyter 和 gRPC,SQLi还有XSS在本地进行检测。需要自己去补充服务:流量包的检测,bash命令的检查。这并非是项目的事情,而是作者的选择。但是如果按照“已集成的流量包进行检测”此类话就去部署生产机会被踩空。拿它当什么用说点实际的判定。BTAB的精准定位是个人分析的工作平台,并非是生产级别的检测工具。它不是像Suricata那样的旁路流量IDS,也没有进行阻断。其价值体现在“人机配合”这一方面:将分析师的拆包,筛字段,切JSON,送检测等机械操作固化成可重复使用的查询话语,把需要进行思考的部分留存到Jupyter里面的脚本里面。能力界限对着瞧:适合用于pcap事后研判,payload批量复检,webshell样本归档,把日常的tshark命令转化成可以重复使用的查询方面的语句。不适用于实时进行流量检测,横向拓展到多机开展分布式解析,需要厂商层级规则库来支撑的情况。技术选择是比较务实的:Go保障了单文件分发的方便情况(前端使用 Go - bindata - assetfs 打包进入二进制,只需要拷贝文件就可以操作),Python担负起分析层,科学计算的生态没有办法被替代,Java只是用来啃取反序列化的数据, gobed 内嵌调用,不需要单独开展服务。在 backend/engine/ 目录当中非测试的GO文件仅仅有16个,并且插件的实现也是非常薄弱的。这意味如果仅仅去学习架构的话,阅读的成本是较低的— —“插件接口加上DSL管道加上多流引用”这三个方面,自己从头开始设计一整套查询的语言,多数会走很多弯路,在这里有现成的参照。要是你仅仅想要一个可以进行蓝队分析的环境,fig. yaml 去配置tshark的路径就可以开始工作;要是想要完整的功能,得先去确认那么几个外部的服务你是否有。