搜索到
4
篇与
的结果
-
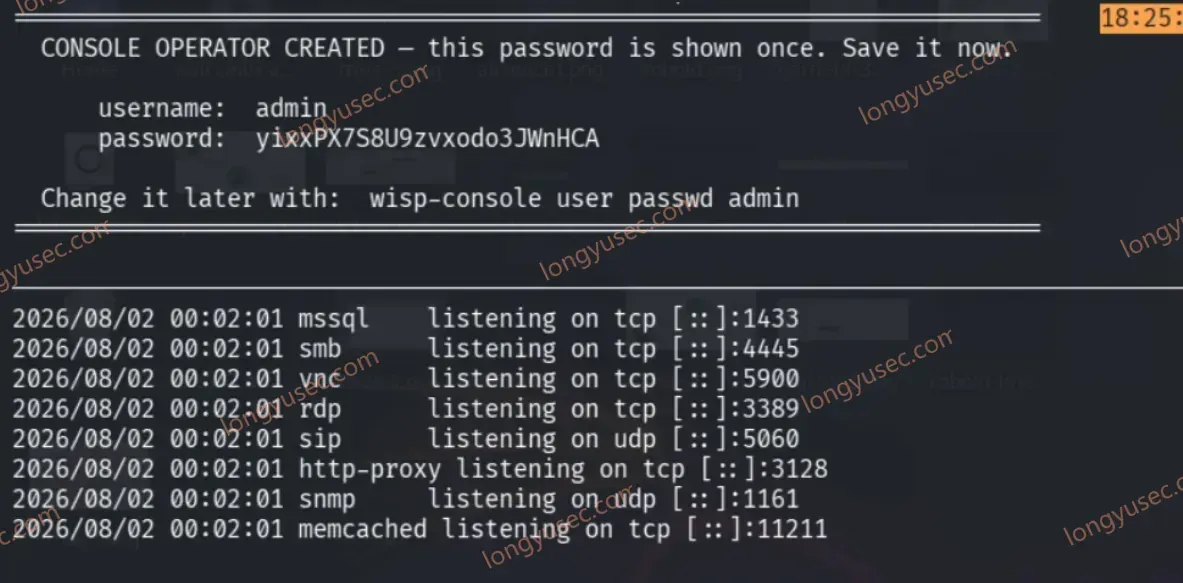
 如果你有一台闲置 VPS,建议看看这个开源蜜罐 wisp 开源地址: https://github.com/iamwillychen/wisp如果你手里只有一台普通 VPS,能不能拿它做一个真正有用的蜜罐?以前我的答案可能会比较谨慎。因为传统蜜罐并不是“开几个端口,记录一下 SSH 登录”这么简单。要模拟的服务越多,依赖越复杂,日志、告警、数据保存也会跟着上来。像 OpenCanary 这样的成熟方案本身就很好,但部署时涉及 Python、Twisted、Scapy,SMB 场景还会牵扯 Samba 等组件。最近看到一个比较新的项目 wisp,思路倒是挺直接:把蜜罐做成一个 Go 编译出来的单体程序,然后直接丢到服务器上运行。更有意思的是,它没有只盯着 SSH、FTP、HTTP 这些传统服务,而是开始模拟 Kubernetes、Docker、云元数据、Jenkins、GitLab、Ollama、MCP 等现在更容易暴露出来的服务。这就让“一台 VPS 做蜜罐”这件事重新变得有意思了。一、wisp 到底是什么?wisp 的定位很明确:Single-binary network honeypot sensor and self-hosted console。简单翻译一下,就是:一个单二进制的网络蜜罐传感器 + 自托管管理控制台。目前项目仍然处于 pre-1.0 阶段,所以它并不是一个已经打磨多年的成熟商业产品。项目作者自己也明确把它和 OpenCanary 做了比较,并承认 OpenCanary 更成熟。但 wisp 有一个很现实的优势:部署简单。项目提供 Go 二进制运行方式,也提供 Dockerfile 和 Docker Compose;传感器和控制台可以分别运行。这对于 VPS 用户很重要。因为很多人不是不会搭蜜罐,而是懒得为了一个蜜罐维护一大串依赖。一个 Python 环境坏了,要修。一个系统包版本不兼容,要修。SMB 又需要额外组件。最后折腾半天,蜜罐还没开始收集数据。wisp 的路线则比较粗暴:VPS │ ├── wispd │ ├── 蜜罐服务 │ ├── 日志 │ └── 可选 Console编译或者拉镜像之后直接跑。二、真正让我觉得它有意思的,不是 SSH 蜜罐如果 wisp 只是做一个 SSH Honeypot,我其实不会专门写它。因为 SSH 蜜罐已经不是什么新鲜东西了。公网 VPS 开一个 SSH 服务,过不了多久通常就会遇到:root admin test ubuntu user之类的用户名尝试。再往后就是各种密码组合。这类数据当然有价值,但问题是:现在攻击者盯着的已经不只是 SSH。尤其是云原生环境越来越普遍以后,攻击面开始往另外几个方向移动。比如:Kubernetes API Kubelet Docker Socket Cloud IMDS Jenkins GitLab Elasticsearch Ollama MCP这些服务一旦暴露出来,攻击者感兴趣的东西也和传统 SSH 爆破不太一样。wisp 的一个核心思路,就是专门针对这些现代基础设施增加“诱饵”。项目目前列出了 9 类 OpenCanary 没有覆盖的新型 decoy,包括 Kubernetes、kubelet、Docker、云 IMDS、Jenkins、GitLab、Ollama 和 MCP 等。这才是我觉得它值得关注的地方。三、为什么 Docker、K8s、MCP 都值得做成蜜罐?因为这些服务背后的信息,可能比一个 SSH 登录失败更加有意思。举个比较容易理解的例子。假设攻击者发现了一个疑似 Ollama 服务。传统蜜罐可能只告诉你:有人连接了这个端口。但 wisp 的 Ollama decoy 可以记录攻击者发送过来的 prompt。项目 README 给出的示例里,甚至直接记录了攻击者尝试让模型执行:cat /etc/shadow这样的请求。最后日志中会留下模型名称、请求路径和 prompt 等信息。这就完全是另一种数据了。你看到的不只是:“有人扫我。”而是:“有人发现了我的 AI 服务,并且下一步准备干什么?”对于研究 AI 基础设施攻击面来说,这种数据明显更有意思。四、Docker 蜜罐就更有意思了Docker 本身已经成为很多服务器上的基础设施。而 Docker Socket 又是一个很特殊的东西。如果一个环境错误地把 Docker Socket 暴露给不可信用户,那么攻击者面对的就不只是一个普通 Web 服务。wisp 针对 Docker 做了对应的 decoy。项目介绍中提到,它可以捕获攻击者尝试提交的容器规格,例如:Privileged: true以及 Host Mount 等信息。这类数据非常适合拿来做攻击行为分析。因为你可以开始观察:攻击者到底想把什么容器跑起来?而不是简单地统计:今天来了多少 IP。两者的信息价值完全不同。五、云服务器还有一个很容易被忽略的攻击面:IMDS如果你经常玩云服务器,应该听过 IMDS。简单来说,云平台实例内部通常存在一个用于获取实例元数据的接口。正常情况下,这东西应该只被特定服务使用。但一旦攻击者能够从一个存在 SSRF 等问题的应用访问到云元数据接口,就可能进一步尝试获取实例相关信息。所以 wisp 把 IMDS 也做成了蜜罐诱饵。这说明它考虑的已经不是:“有人正在扫描我的 SSH。”而是:“如果攻击者把一台云服务器当成目标,他接下来会寻找什么?”这也是现代蜜罐和传统蜜罐之间比较明显的区别。六、MCP 甚至也被放进来了这一点可能是 wisp 最“2026”的地方。现在很多 AI Agent 开始通过 MCP 连接外部工具和数据。MCP 本身并不是攻击工具,但一旦 Agent、MCP Server、工具权限和敏感数据混在一起,安全问题就会变得复杂。wisp 直接增加了 MCP decoy。它甚至支持 MCP 类型的 honeytoken。也就是说,你可以把一个看起来像 MCP 配置的东西放进环境中。如果有人或者某个 Agent 加载了这个配置并进行连接,就能够产生对应事件。项目目前的 token 类型还包括 HTTP、DNS、Word 文档、kubeconfig 和 MCP。七、那一台普通 VPS 到底能不能跑?答案是:可以,而且这恰恰是 wisp 这种项目比较有吸引力的地方。因为它不是把整套 SIEM、ELK、几十个容器全部塞进 VPS。最简单的情况下,一个 wispd 就可以作为传感器运行。项目默认配置甚至可以直接启动:./wispd如果想进一步部署管理控制台,则可以再运行:wispd ↓ Sensor ↓ HTTPS wisp-console ↓ SQLite ↓ 事件 / 告警 / 查询控制台本身也是 Go 程序,项目采用 SQLite 保存数据。所以从架构上来说,它并不要求你一开始就准备一台很夸张的服务器。八、不过,公网 VPS 部署蜜罐有一个原则蜜罐和业务服务器最好不要放一起。这一点比 CPU、内存配置重要得多。如果你有一台正在跑网站的 VPS:网站 数据库 Docker 个人文件 SSH 蜜罐全部放在一起,然后直接把蜜罐暴露到公网。这不是一个特别好的实验方案。因为蜜罐的核心工作就是:故意让不可信流量接近它。而它又需要解析攻击者发送过来的各种输入。所以更合理的思路是:业务服务器 │ │ │ 隔离 ▼ 蜜罐 VPS │ ├── wisp ├── 日志 └── Console最好再通过防火墙限制管理端口。真正需要暴露到公网的,是你准备拿来“吸引访问”的那些服务端口。管理控制台不要因为图省事直接裸奔。九、蜜罐最怕的其实不是攻击,而是“被攻击以后失控”很多人第一次搭蜜罐会有一个误区:“反正是假的,随便开。”恰恰相反。蜜罐应该是:看起来像真的,但实际上什么都不能真的做。wisp 自己也强调这一点。例如认证请求不会真正放行;容器、服务和系统环境都是诱饵。项目提供的 Docker 部署还采用了非 root 用户、只读根文件系统、删除能力权限以及 no-new-privileges 等限制。这其实是蜜罐设计里非常关键的一层:攻击者 ↓ 诱饵服务 ↓ 记录行为 ↓ 告警 ↓ 结束而不是:攻击者 ↓ 诱饵服务 ↓ 真的执行命令 ↓ 真的访问宿主机 ↓ 寄蜜罐的任务是观察攻击行为,不是给攻击者提供一个免费的 VPS。十、日志比“攻击次数”重要搭蜜罐最容易犯的第二个错误,是只看:今天有 132 个 IP 扫描。这个数字看起来挺刺激。但其实没那么重要。真正值得分析的是:谁 ↓ 什么时候 ↓ 访问什么服务 ↓ 发送了什么请求 ↓ 尝试使用什么凭证 ↓ 下一步想干什么wisp 的日志可以输出 JSONL,每条事件包含时间、节点、服务、源 IP、目标端口以及捕获的数据。而且这些 JSON 日志可以进一步交给 Vector、Filebeat 或 SIEM。这样一来,一台几十块钱级别的 VPS 就不只是:“放一个蜜罐玩玩。”而可以变成一个小型的攻击情报采集节点。十一、如果只有一台 VPS,我会怎么规划?如果只是个人学习或者做实验,我反而不会一开始搞得特别复杂。可以按照这个思路:公网 VPS │ ├── wisp Sensor │ ├── 日志 │ └── 防火墙先观察一段时间。等数据量起来之后,再考虑:VPS 01 └── wisp Sensor VPS 02 └── wisp Sensor VPS 03 └── wisp Sensor ↓ wisp Console ↓ SQLite ↓ 告警 / 分析这时候就从“个人蜜罐”变成了一个小型蜜罐网络。而 wisp 的 Console 本身就是为了多个 sensor 集中管理设计的。传感器通过 HTTPS 向 Console 上报事件,并使用独立 token 进行注册。十二、一台 VPS 做蜜罐,最值得玩的其实是这个思路以前大家搭蜜罐,关注的是:SSH、FTP、Telnet、Web。现在可以开始换一个思路:传统服务器 ↓ SSH / FTP / SMB 云原生服务器 ↓ Docker Kubernetes IMDS CI/CD AI 服务器 ↓ Ollama LLM API MCP Agent 未来的蜜罐 ↓ 传统攻击面 + 云原生攻击面 + AI 攻击面wisp 的价值就在这里。它并没有试图证明传统蜜罐已经过时。实际上,项目自己也承认 OpenCanary 更成熟。它做的是另一件事情:把蜜罐的诱饵面往现在的云、容器和 AI 基础设施扩了一圈。这也是为什么我觉得这个项目值得关注。最后:VPS 真的可以成为一个安全研究工具很多人买 VPS,第一反应都是:建站。其实服务器本身就是一个很好的安全实验环境。你可以拿它做:蜜罐日志分析威胁情报采集安全监控Docker 安全实验AI Agent 实验MCP 安全研究内网实验环境而像 wisp 这种项目,把“部署一个蜜罐”的门槛又往下压了一截。它现在还年轻,项目本身也明确标注了 pre-1.0,所以没必要把它包装成什么“下一代蜜罐终结者”。更准确的说法应该是:它正在尝试回答一个很现实的问题:如果今天重新设计一个蜜罐,除了 SSH 和 Web,我们是不是应该把 Docker、Kubernetes、云服务以及 AI 基础设施也考虑进去?至少从 wisp 目前的设计来看,答案已经很明显了。如果你手里刚好有一台闲置 VPS,拿它做个隔离的蜜罐节点,倒是一个挺有意思的玩法。服务器选择如果你准备拿 VPS 做蜜罐、安全监控或者 Docker 实验,建议优先考虑独立服务器环境、稳定公网 IP、足够的磁盘空间以及可控的防火墙策略。蜜罐本身并不需要一上来就堆很高的配置,先从低成本节点观察真实流量,再根据日志量决定是否扩容,通常更合理。
-
如何看待当下的AI挖洞?AI挖洞有没有前途 这两年做渗透测试、漏洞挖掘的人,应该都有一个越来越明显的感觉:AI 真的开始进场了。以前我们说“AI 挖洞”,多少还有点像一个概念。让大模型帮你分析代码、看看请求、解释一个漏洞,这些事情早就能做。但真到了 2025、2026 年,情况已经开始不一样了。现在的 AI 不只是“帮你写 Payload”。它开始自己读代码、分析程序、调用工具、运行测试、验证漏洞,甚至尝试修改补丁。所以很多刚入行的人会开始问一个很现实的问题:以后还需要学渗透测试吗? AI 都能自己挖漏洞了,人还有什么价值?我的看法是:AI 挖洞肯定有前途,而且这个方向已经不是“有没有前途”的问题了,而是它已经开始成为漏洞研究的一部分。但另一件事也是真的:现在就说“以后 AI 可以完全替代渗透测试人员”,还早。一、先别急着说“AI 要取代黑客”,现在它已经能干什么?先看几个比较实际的变化。DARPA 的 AI Cyber Challenge(AIxCC)本身就是一个很典型的例子。这个项目专门研究利用 AI 自动发现、分析和修复软件漏洞。在 2024 年的半决赛中,参赛系统发现了 22 个独特的人工植入漏洞,并修复了其中 15 个,同时还发现过 SQLite 中的真实世界漏洞。到 2025 年的最终竞赛,AI 系统已经被要求在更复杂的软件环境里同时完成漏洞发现和修复。这说明一个问题:AI 挖漏洞已经不是 PPT 里的概念了。Google 这边也在做类似的事情。Google DeepMind / Project Zero 的 Big Sleep 已经被用于漏洞发现,Google 在 2025 年公开表示,它曾发现包括 SQLite 在内的真实世界漏洞;到 2026 年,Google 又表示已经把基于 Gemini 的 agent harness 扩展到了更大范围的 Chrome 代码库。OpenAI 也已经推出了 Codex Security research preview,用 agent 去理解项目上下文、寻找复杂漏洞、验证结果,并尝试生成修复方案。所以现在再说:“AI 只能写写代码,根本不会真正挖漏洞。”这个判断已经站不住了。二、但是 AI 挖洞和我们理解的“挖洞”,其实不是一回事很多人第一次接触 AI 挖洞,会产生一个误解:给 AI 一个网站。 然后 AI 自己扫描。 找到漏洞。 自动验证。 最后提交报告。如果真能稳定做到这个程度,那确实非常吓人。但现实距离这个状态还有明显差距。因为真正的漏洞研究,往往不是:“这里有没有漏洞?”而是:“这个功能到底是怎么工作的?”这两个问题完全不一样。举个很简单的例子。一个普通的 IDOR,你可能一眼就能发现:代码语言:javascriptAI代码解释/user/profile?id=1001改成:代码语言:javascriptAI代码解释/user/profile?id=1002然后看返回结果。这属于比较典型的自动化任务。但如果开发人员做了三层权限判断:代码语言:javascriptAI代码解释前端权限 ↓ API 权限 ↓ 业务对象权限而真正的问题出现在第三层。这时候就不是简单改个 ID 能解决的。你需要理解:用户角色之间有什么区别;对象属于谁;服务端到底在哪一步做权限判断;哪些接口共享同一个业务对象;某个状态变化之后权限模型有没有发生变化。这时候真正值钱的其实不是“会不会发请求”。而是:你有没有能力建立业务模型。三、AI 现在最强的地方,其实不是“发现神洞”,而是“扩大搜索面积”这一点我觉得特别重要。很多人讨论 AI 挖洞,总喜欢拿“AI 能不能发现一个超级复杂 0day”来判断它有没有价值。其实这个角度有点偏。AI 最大的优势可能根本不是:一次挖出别人十年没发现的神级漏洞。而是:以前一个人只能看 10 万行代码,现在可以让几十个 agent 同时帮你分析。这才是真正恐怖的地方。人类的问题是什么?时间有限。精力有限。注意力有限。一个研究员一天可能认真分析几个模块。但是机器可以同时跑大量任务。比如:代码语言:javascriptAI代码解释代码审计 ↓ 自动定位高风险函数 ↓ 生成测试用例 ↓ 尝试构造输入 ↓ 运行程序 ↓ 观察异常 ↓ 再次调整输入 ↓ 验证漏洞这个过程如果全部交给人工,成本非常高。但 AI Agent 可以把大量重复劳动吃掉。所以以后非常可能出现一种情况:不是 AI 替代漏洞研究员,而是“一个漏洞研究员 + 一堆 AI Agent”。一个人带着十个、二十个甚至更多自动化研究任务同时跑。这才是我觉得比较现实的未来。四、AI 挖洞真正的问题,其实是“误报”这个问题很多宣传文章不会重点讲。因为“AI 一晚上发现 5000 个漏洞”听起来很夸张。但你真正把结果打开:代码语言:javascriptAI代码解释Finding 0001 Finding 0002 Finding 0003 Finding 0004 ...然后发现:其中一大堆根本没法利用。还有一些:重复漏洞。再有一些:只是理论风险,实际攻击链根本走不通。这就麻烦了。HackerOne 在 2026 年公开讨论过这个问题:随着 AI 能力增强,漏洞报告数量明显上升,但增加的报告并不全部具有同等价值,其中会包含重复、无法验证、缺乏足够技术深度的提交。其平台 2026 年 3 月的报告量达到 46,947 份,同比增长 76%,而确认可利用的比例大约仍在四分之一左右。所以:发现 1000 个结果,不等于发现 1000 个漏洞。真正重要的是:代码语言:javascriptAI代码解释发现 ↓ 验证 ↓ 利用 ↓ 判断影响 ↓ 去重 ↓ 形成完整漏洞链 ↓ 写出别人能复现的报告最后这几步,目前仍然非常依赖人的判断。五、还有一个 AI 不太容易处理的问题:业务逻辑这个可能是我最看好的一个方向。因为很多漏洞并不是代码层面那种特别标准的:代码语言:javascriptAI代码解释SQL Injection XSS RCE SSRF而是:业务设计本身有问题。例如:一个平台正常流程是:代码语言:javascriptAI代码解释注册账号 ↓ 购买商品 ↓ 支付 ↓ 生成订单 ↓ 获得权益结果你研究半天发现:代码语言:javascriptAI代码解释优惠券校验在 A 接口 订单价格校验在 B 接口 最终权益发放在 C 接口然后 A、B、C 三个接口分别看起来都没什么问题。但是组合起来:就出问题了。这种漏洞特别依赖研究员自己的理解。你需要站到业务设计者的角度去想:“如果我是开发,这三个接口为什么这样设计?”然后再反过来找:“有没有哪一个状态,可以被我人为制造出来?”这类东西,确实是 AI 很想攻克、但目前仍然比较困难的地方。六、所以以后还值得学 Web 漏洞吗?我觉得更应该学。只是学习方式要变。以前可能是:代码语言:javascriptAI代码解释学 HTTP ↓ 学 Web 漏洞 ↓ 学 Burp ↓ 学扫描器 ↓ 刷靶场 ↓ 找漏洞以后更合理的路线应该是:代码语言:javascriptAI代码解释理解 Web 原理 ↓ 理解漏洞原理 ↓ 学会人工验证 ↓ 学会代码审计 ↓ 学会使用 AI ↓ 学会编排 Agent ↓ 人工 + AI 联合研究也就是说:以后最危险的不是“不会 AI 的安全人员”。真正容易被淘汰的,反而可能是:只会机械执行固定流程的人。比如:代码语言:javascriptAI代码解释打开 Burp ↓ 扫目录 ↓ 跑扫描器 ↓ 复制结果 ↓ 提交报告这一整套工作,本身就特别适合自动化。AI 只是让这个自动化过程进一步升级。七、那“AI 挖洞”到底有没有前途?如果你问我的判断:有,而且会越来越重要。但我不建议把它理解成:“以后 AI 自己挖洞,人就不用学了。”我反而更倾向于认为,未来会出现一种新的漏洞研究模式:代码语言:javascriptAI代码解释人 │ ├── 定义目标 ├── 理解业务 ├── 提出假设 ├── 设计攻击思路 └── 判断最终影响 │ ▼ AI Agent │ ┌──────┼──────┐ ▼ ▼ ▼ 代码审计 测试 验证 │ │ │ └──────┼──────┘ ▼ 人工复核 ▼ 最终结论AI负责大量重复工作。人负责真正困难的判断。这个分工,我觉得反而非常合理。八、以后什么样的人更吃香?这个问题其实比“AI 有没有前途”更值得问。如果一个人现在只会:“这个参数可能存在 SQL 注入,我用一下工具。”那确实会越来越卷。但是如果你能够做到:“我理解这个系统的业务逻辑,我知道它的数据怎么流动,我可以根据异常行为提出假设,再让 AI 帮我快速验证。”那完全是另外一个层级。未来真正有价值的能力,我觉得会逐渐向这几个方向集中:第一,漏洞原理。不是背 Payload。而是知道为什么这个 Payload 能成功。第二,代码理解。至少要能够读懂常见的 Web 后端逻辑。第三,业务理解。尤其是支付、权限、订单、身份、云服务这些复杂系统。第四,AI 使用能力。不是简单问 ChatGPT:“帮我找一下这个漏洞。”而是能够让 AI 成为你的研究助手。第五,验证能力。AI 说有漏洞,不代表真的有。你得自己证明。这一点以后可能反而越来越重要。九、最后说一个可能不太好听的事实AI 对漏洞挖掘最大的改变,可能不是:“以后 AI 会不会挖洞。”而是:“漏洞的产能可能会突然提高很多。”过去一个研究员一天能分析多少东西,有比较明显的上限。以后这个上限可能会被 AI 大幅度提高。于是问题就会从:“谁能找到漏洞?”慢慢变成:“谁能在海量自动化结果里找到真正有价值的漏洞?”这其实又回到了人的能力。你看得懂代码吗?你理解业务吗?你能判断攻击链吗?你能区分一个普通低风险问题和一个真正有影响的漏洞吗?你能让 AI 按照你的思路去工作吗?这些东西,才可能是未来几年真正拉开差距的地方。写在最后所以对于现在还在学渗透测试、漏洞挖掘的人,我反而不建议因为 AI 出现就开始焦虑。真正应该警惕的是另一件事情:还在用几年前的方式学习。以前我们可能花大量时间记工具参数、背 Payload、刷重复靶场。以后这些东西依然有用,但它们的边际价值可能会越来越低。真正值钱的,是你脑子里那套:发现问题 → 提出假设 → 验证假设 → 建立攻击链 → 判断影响AI 可以帮你把前面的路跑得更快。但最后那个“为什么这个系统会出问题”,依然需要有人真正想明白。所以 AI 挖洞有没有前途?答案其实已经不是一个未来时。它已经开始发生了。现在真正值得考虑的问题应该变成:当 AI 开始参与漏洞研究以后,你想成为被 AI 替代的人,还是使用 AI 的那个人?这个选择,可能比“AI 会不会挖洞”本身重要得多。
-
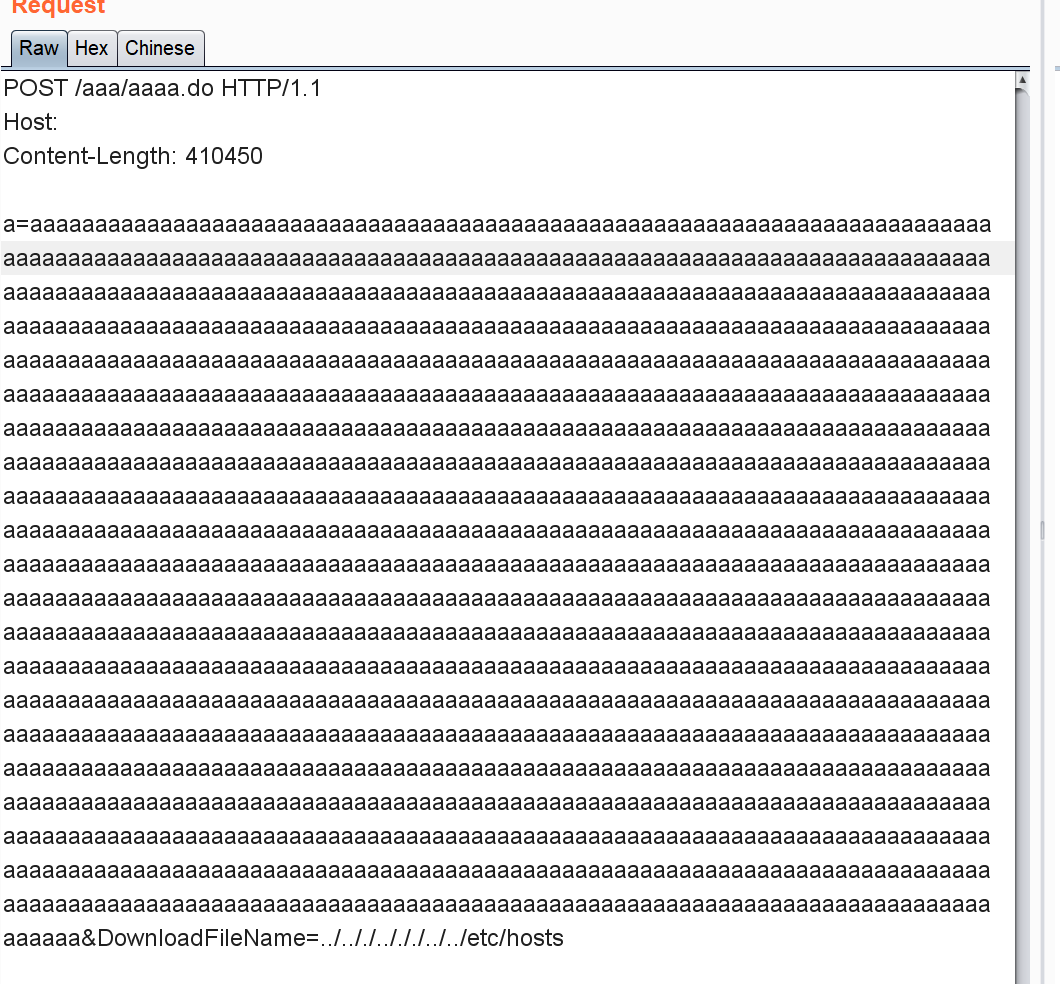
HW 中如何利用 WAF 缺陷进行绕过 在挖洞过程中,往往会遇到各种攻击利用被WAF拦截的情况,本文浅析总结了常见的一些绕过思路以及具体实现浅析WAF绕过在挖洞过程中,往往会遇到各种攻击利用被WAF拦截的情况,本文浅析总结了常见的一些绕过思路以及具体实现利用WAF的缺陷绕过1.1利用WAF性能缺陷-垃圾字符填充对于通用性较强的软WAF来说,不得不考虑到各种机器和系统的性能,故对于一些超大数据包、超长数据可能会跳过不检测因此可以填充大量垃圾字符来逃避WAF对数据包的检测如下1.2利用WAF性能缺陷-发送大量请求包可以采取高并发的攻击手段,WAF同样出于性能考虑可能会直接放行部分数据包。2.利用WAF适配组件的缺陷由于后端web容器、中间件、数据库、脚本语言的多样性,waf很难覆盖全,容易导致waf解析不了而后端可以正常解析读取导致的绕过IIS+asp在IIS+ASP的环境中,如果url中出现了百分号,但后面邻接的字符拼起来后又不在url编码表之内的话,ASP脚本处理时会将其忽略例如假设有如下请求xxx.asp?id=1 union se%lect 1,2,3,4 fro%m adm%inwaf规则不严放行后,后端由于该特性成功处理执行了xxx.asp?id=1 union select 1,2,3,4 from admin导致绕过TOMCATtomcat的特性也可以构造出许多绕过的方式,可以参考https://y4tacker.github.io/2022/06/19/year/2022/6/%E6%8E%A2%E5%AF%BBTomcat%E6%96%87%E4%BB%B6%E4%B8%8A%E4%BC%A0%E6%B5%81%E9%87%8F%E5%B1%82%E9%9D%A2%E7%BB%95waf%E6%96%B0%E5%A7%BF%E5%8A%BF/这篇文章1.参数前后添加空白字符绕过filename="1.jsp"的filename字符左右可以加上一些空白字符%20 %09 %0a %0b %0c %0d %1c %1d %1e %1f,比如%20filename%0a="1.jsp"这样导致waf匹配不到我们上传⽂件2.utf-16、cp037等各种编码绕过utf-16cp037(原始payload为' and (7=len(db_name())) and 'a' = 'a)json下的unicode编码3.利用waf适配协议的缺陷3.1畸形请求(与Web应用所处的中间件有关,在部分中间件下不适用)将HTTP请求头变为随机字符串例如xxxxT请求方法后加一个table等空字符使用get请求方法但带上post体(需要服务端能正常接受)3.2分块传输仅仅适用于post传输方法分块传输不少waf现在也都可以识别了,可以结合waf性能缺陷的思路综合利用-延时分块传输具体使用可以参考该项目 http://github.com/c0ny1/chunked-coding-converter3.3非预期请求方式get改为post、Content-Type: application/x-www-form-urlencoded改为multipart/form-data等跳过waf直接访问服务器寻找真实ip绕过云waf云waf通过配置NS或者CNAME记录,使得对网站的请求报文优先经过WAF主机,经过WAF主机过滤之后,将被认为无害的请求报文再送给实际的网站服务器进行请求,此时只要找到服务器的真实ip,修改host为服务器真是ip即可绕过云waf常见寻找真实ip的方式有如下几种1.证书信息查询 https://myssl.com/2.dns历史解析记录3.搜集子域名ip c段(考虑到费用问题,一些子域名并不会部署)4.超级ping......寻找没有部署waf的nginx反代机器当waf在nginx服务器上部署,且存在nginx集群时,可以试试尝试寻找能反代服务却又没用部署waf的机器访问进行绕过以下面这个为例,测试某接口发现被拦截搜集ip信息为xxx.xxx.200.1xx查找c段服务,一个个访问尝试利用成功利用waf白名单WAF存在某些机制,不处理和拦截白名单中的请求数据例如特定的ip,来自于搜索引擎爬虫的访问数据等特定ip可以使用https://github.com/TheKingOfDuck/burpFakeIP插件将xff等头部设置为127.0.0.1等进行绕过尝试搜索引擎爬虫的访问数据User-Agent修改为谷歌搜索引擎等原文链接:https://forum.butian.net/share/3639
-