搜索到
10
篇与
的结果
-
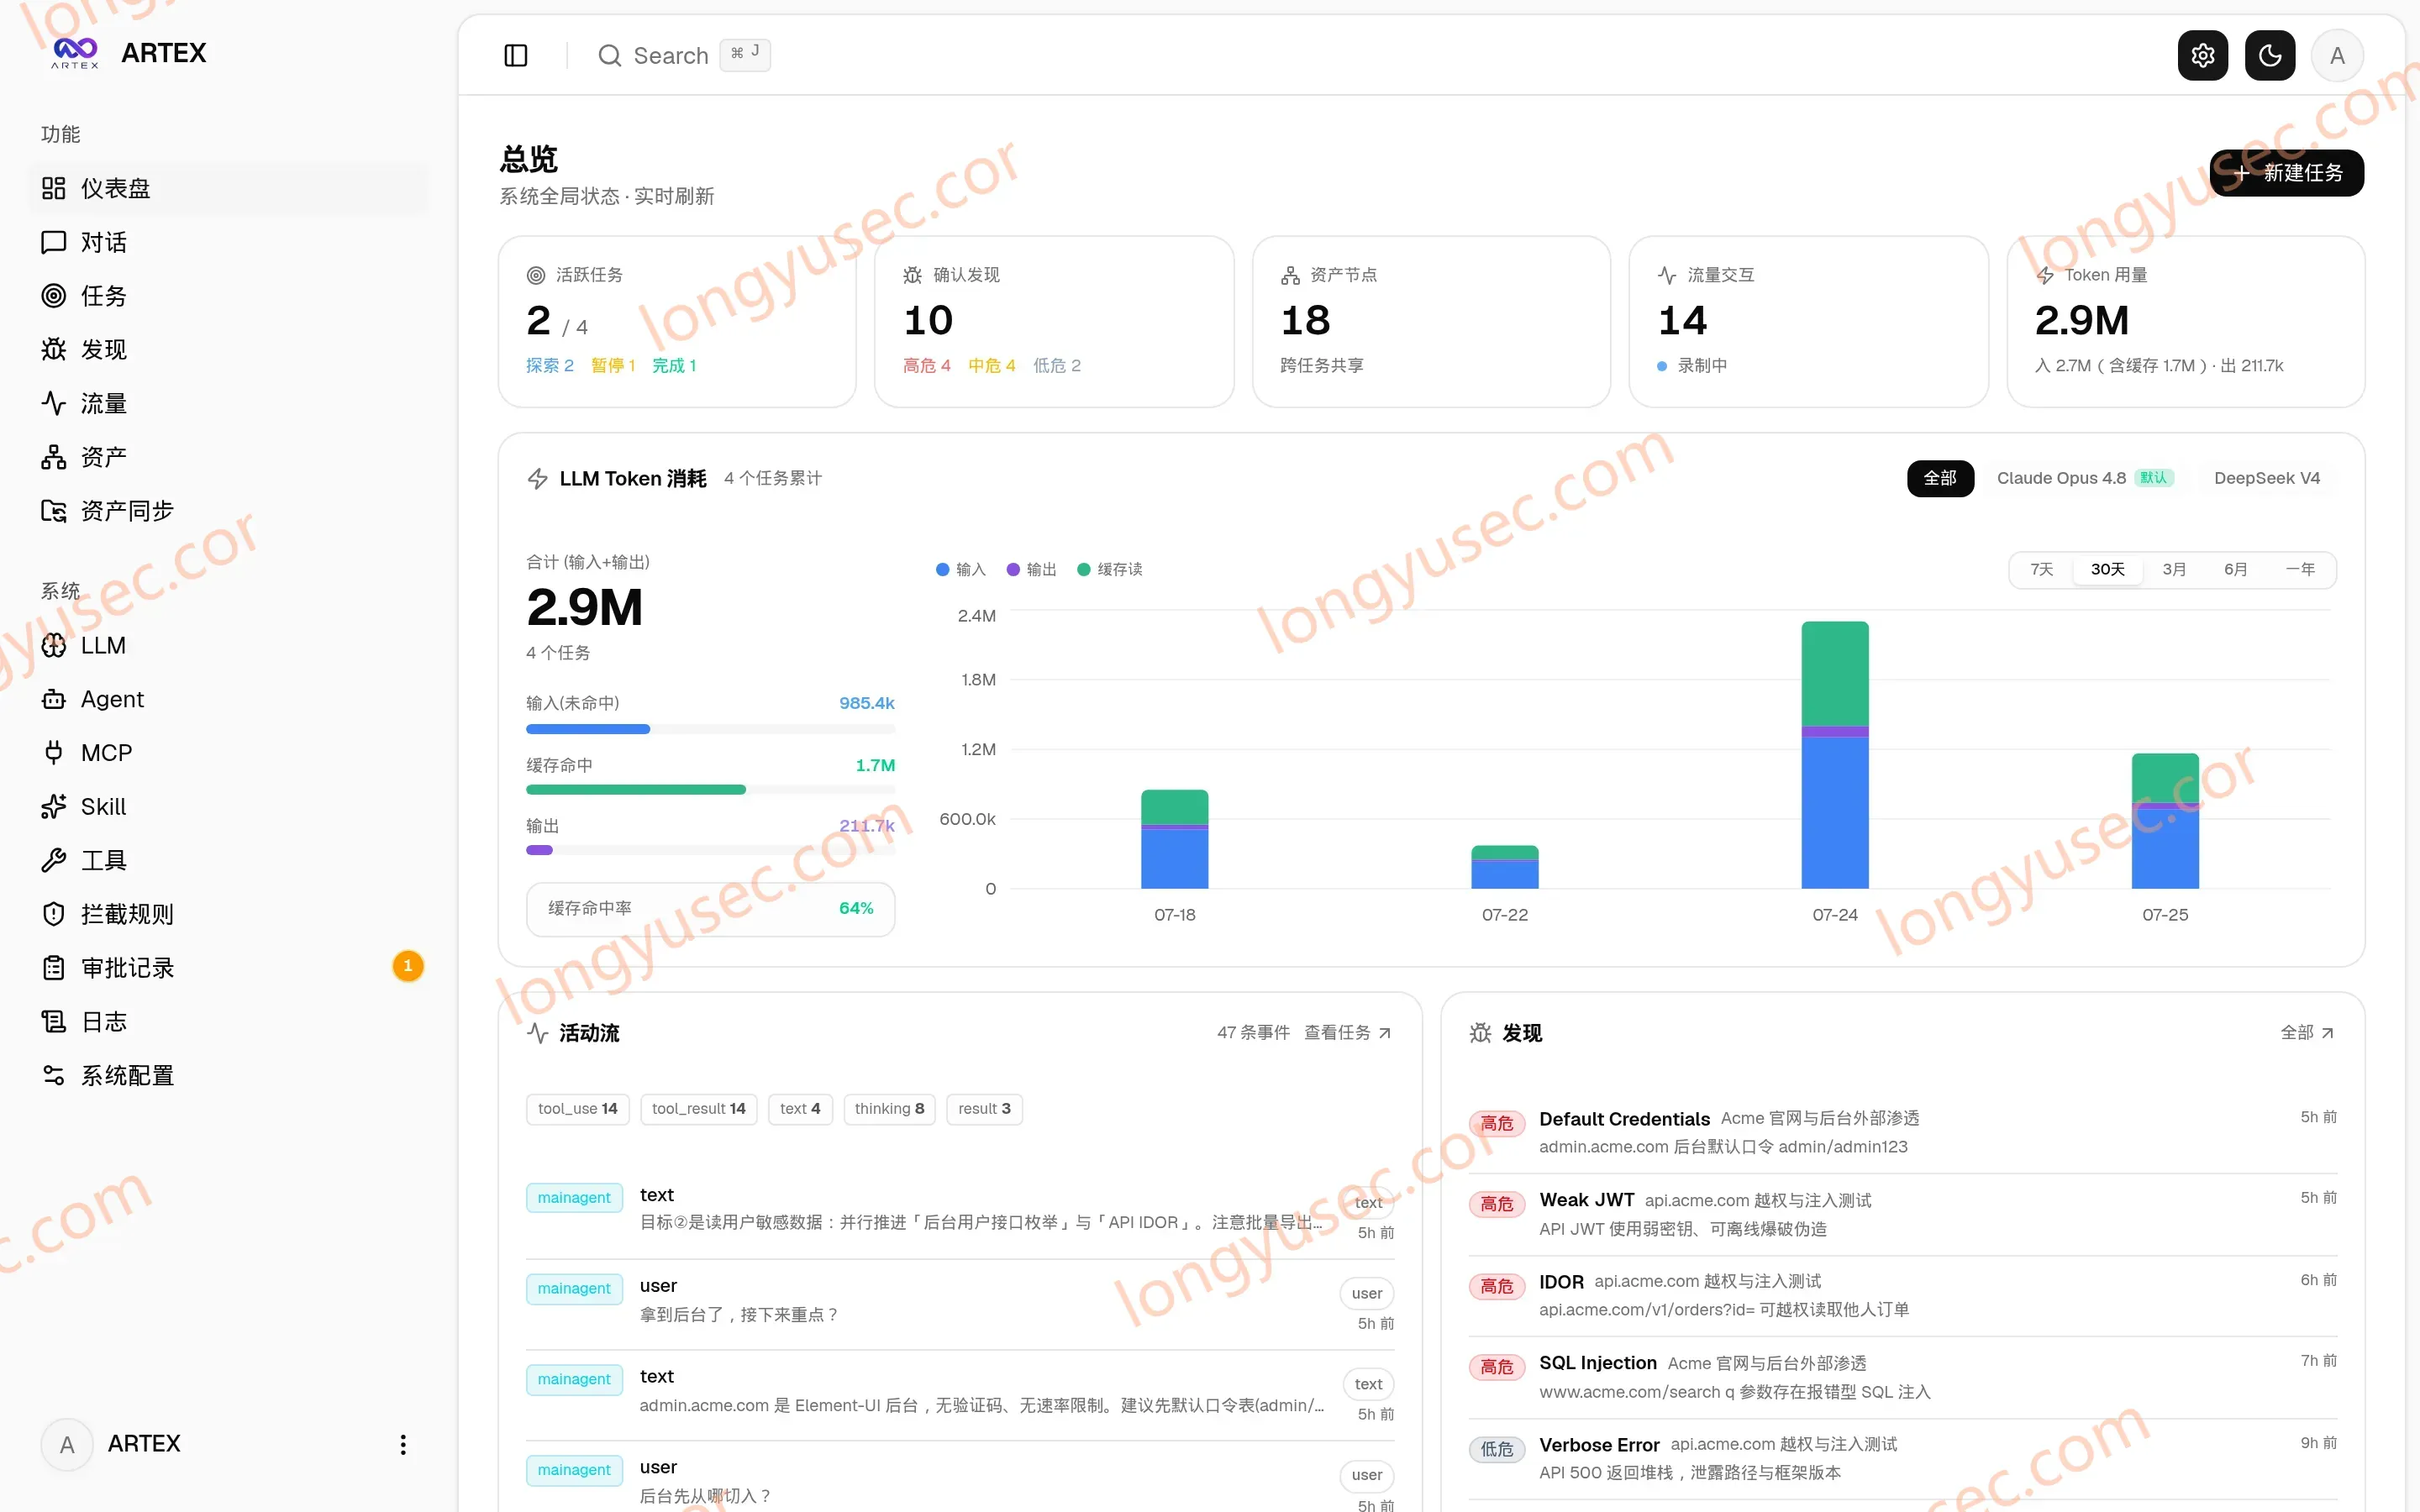
 做渗透测试的人,为什么需要一个漏洞管理平台?ARTEX项目分析 做渗透测试的时候,真正让人头疼的往往不是“找不到漏洞”,而是测试做到后面,突然不知道自己到底测了什么。域名、子域名、IP、端口、站点、接口、漏洞、请求记录散落在不同工具里,发现一个问题还要自己截图、整理证据。目标一多,测试过程就很容易变成一堆零散的信息。所以做渗透测试,除了扫描和漏洞验证,其实还需要解决一个问题:怎么把整个测试过程管理起来?最近比较有意思的一个开源项目是 ARTEX,它是一套 AI 自主渗透测试系统,采用 Go + Next.js 架构,把 AI Agent、资产管理、探索过程、工具调用、漏洞发现和人工审批放到了一起。ARTEX 不只是一个“AI 扫描器”如果把 ARTEX 简单理解成“让 AI 自动跑 Nmap”,其实有点低估这个项目了。传统扫描器通常是输入目标,然后等待结果;ARTEX 更接近一个持续运行的 Agent 工作流:目标 ↓ 资产发现 ↓ AI 分析 ↓ 制定下一步计划 ↓ 调用工具 ↓ 获得结果 ↓ 更新资产 / 发现 ↓ 继续探索所以它需要记录的东西,自然也不只是最后的漏洞。ARTEX 有独立的任务管理,可以把一次测试作为完整任务保存下来。任务执行过程中,Agent 的会话和工具调用也会被记录下来。这点其实非常重要。因为 AI 最终告诉你“这里可能存在一个漏洞”,并不能说明问题已经结束。你还需要知道它为什么得出这个结论、调用了什么工具、获得了什么结果,以及有没有足够的证据支撑。资产和探索,是 ARTEX 比较有意思的地方ARTEX 对资产进行了独立管理,可以记录 root domAIn、subdomAIn、IP、service、app、endpoint 等不同类型的资产,并处理资产之间的关联和去重。除此之外,还有一个探索图。它记录的不是简单的“扫描结果”,而是 AI 在测试过程中产生的目标、意图、事实和发现。这也是 AI Agent 和传统自动化脚本比较明显的区别。脚本一般按照固定流程执行,而 Agent 可以根据前面获得的信息决定下一步做什么。某个结果出现以后,可能产生新的资产、新的事实,然后继续触发下一轮探索。ARTEX 的架构里,Planner 负责规划,Worker 负责执行,执行结果再重新写回系统。简单理解就是:Planner → 生成任务 ↓ Worker → 执行工具 ↓ 产生新信息 ↓ 更新探索状态 ↓ Planner 再判断下一步漏洞发现以后,还需要管理什么?安全测试最容易被忽略的一环,其实是复测。漏洞发现以后,开发人员修复,测试人员还需要重新确认到底有没有修好。如果漏洞数量比较多,这件事本身就会变成一个工作量。ARTEX 已经把漏洞复测纳入了测试流程,可以针对之前发现的问题重新发起复测,并记录“仍可复现、已修复、无法确认”等结果。这样管理的就不再只是:发现过哪些漏洞?而是:这个漏洞现在到底是什么状态?这才更接近真正的漏洞生命周期管理。AI 也不能完全放开跑另一个比较值得注意的设计是人在环路。ARTEX 还提供了拦截审批功能。也就是说,AI 可以负责分析、规划和调用工具,但涉及需要人工确认的操作时,可以进入审批流程。对于 AI 安全测试来说,这种设计其实比单纯追求“全自动”更加现实。毕竟安全测试和普通自动化任务不一样,目标范围、操作权限以及测试行为都需要明确控制。自己部署难不难?ARTEX 支持 Docker Compose、一键安装、预编译版本和源码编译。使用 Docker 部署的话,基本流程就是:git clone https://github.com/Autumn-27/ARTEX.git cd ARTEX cp .env.example .env Docker compose up -d启动后访问:http://localhost:8787项目使用 PostgreSQL,AI 探索需要配置 LLM,目前支持 Anthropic 和 OpenAI。如果准备放到 VPS 上运行,也不建议单纯按照“最低配置”来选机器。实际资源消耗还和 Agent 数量、并发任务、数据库规模以及工具运行情况有关。自己学习的话,可以先从小规格 VPS 开始,根据实际运行情况再调整。最后所以回到最开始的问题:做渗透测试的人,为什么需要一个漏洞管理平台?因为当测试规模变大以后,真正需要管理的已经不只是漏洞。还有资产、测试任务、Agent、工具调用、探索过程、流量、证据以及后续复测。ARTEX 有意思的地方,也恰恰不是“AI 能不能找到一个漏洞”,而是它开始尝试把这些东西串成一个完整的安全测试工作流。对于想研究 AI Agent + 网络安全 的人来说,这类项目比单纯的 AI 扫描器更值得关注。需要注意的是,这类工具应当用于自己的实验环境、隔离靶场或明确获得授权的测试目标,不要直接对未知公网目标进行扫描或测试。如果你准备自己搭建 AI 安全测试环境,可以根据实际需求选择云服务器:1、
-
多个 AI Agent 同时运行时,服务器资源到底该怎么规划? 最近折腾 AI Agent 的人越来越多了。一开始通常只跑一个 Agent。比如一个负责查资料,一个负责写代码,再加一个负责执行自动化任务。单个跑的时候感觉服务器完全够用,CPU 也没怎么动,内存还有很多剩余。于是很容易产生一个错觉:“我这台机器跑一个 Agent 绰绰有余,那跑十个应该也没问题吧?”真正把 Agent 数量堆起来以后,往往就不是这么回事了。因为多个 Agent 同时运行,消耗的并不只是模型本身的资源。上下文、工具调用、浏览器、Python 进程、Docker 容器、向量数据库、缓存、网络连接,甚至 Agent 卡住以后堆积起来的任务队列,都会开始抢资源。所以如果准备长期运行多个 Agent,服务器规划最好别只看“模型多少 B”。更应该看的是:到底有多少任务同时执行,以及每个任务会把多少资源占住。一、先把一个 Agent 拆开看很多人估算服务器配置的时候,第一反应是:“这个模型需要多少显存?”这当然重要,但只解决了一部分问题。一个比较完整的 Agent 环境,通常至少包含下面几层: AI Agent │ ┌──────────────┼──────────────┐ ▼ ▼ ▼ LLM模型 工具调用 记忆/上下文 │ │ │ ▼ ▼ ▼ GPU/显存 CPU/内存 RAM/磁盘 │ ┌────────┴────────┐ ▼ ▼ 浏览器/代码执行 数据库/向量库 │ │ └────────┬────────┘ ▼ 网络 IO所以一个 Agent 的资源消耗,大概可以理解成:模型资源 + Agent运行时 + 工具资源 + 数据资源 + 并发带来的额外开销。而且不同 Agent 的资源模型完全不一样。一个纯 API 型 Agent,可能大部分时间只是在发 HTTP 请求。一个代码 Agent,可能突然启动 Python、Node.js、Docker。一个浏览器 Agent,则可能同时拉起 Chromium,内存一下子就上去了。还有一些长期运行的 Agent,会不断积累上下文、缓存和任务状态。这也是为什么:“我跑一个 Agent 很流畅”并不能直接推导出“我能同时跑十个 Agent”。二、多个 Agent 最先遇到的,通常不是 GPU,而是内存如果你的 Agent 主要调用外部模型 API,而不是自己在服务器上部署大模型,那么 GPU 甚至可能不是主要矛盾。这时候最值得关注的是 RAM。例如一台机器上同时跑:5 个 Agent5 个 Python Runtime5 个任务队列一个 Redis一个数据库2~3 个浏览器实例Docker日志服务监控模型虽然在云端,但这些东西全部在你的服务器上。这时候 8GB、16GB 和 32GB 内存的实际体验可能差得非常明显。尤其是浏览器型 Agent。Chromium 本身就可能启动多个进程,如果每个 Agent 都拥有独立浏览器环境,那么内存消耗很容易随着并发数往上涨。所以如果你准备运行的是:API Agent → 内存压力相对可控代码 Agent → CPU + 内存明显增加浏览器 Agent → 内存压力进一步增加本地模型 Agent → GPU/显存成为核心资源不要把这几种场景混在一起算。三、如果是本地模型,真正需要算的是“显存 + 并发”本地部署模型以后,问题就复杂了一层。很多人只看模型参数量。比如:7B 模型能不能放进 16GB 显存?这个问题其实只是第一关。模型放得进去,不代表多个 Agent 同时调用的时候就一定舒服。因为推理过程中还需要考虑 KV Cache,以及并发请求带来的额外显存占用。以 Ollama 的并发机制为例,当系统有足够的 CPU 内存或 GPU VRAM 时,可以同时加载多个模型并处理并行请求;同一个模型增加并行请求后,所需的上下文空间也会随之增加。Ollama 还提供了 OLLAMA_NUM_PARALLEL、OLLAMA_MAX_LOADED_MODELS 和 OLLAMA_MAX_QUEUE 等参数控制并发、模型加载数量和等待队列。这其实说明了一个很现实的问题:模型大小只是固定成本,并发才是动态成本。假设:Agent A ─┐ Agent B ─┤ Agent C ─┼──> 同一个模型 Agent D ─┤ Agent E ─┘五个 Agent 不一定意味着需要五份完整模型。但它们的上下文、请求、KV Cache 和运行状态会同时存在。于是服务器真正面对的是:模型能不能装下?变成:模型装下以后,还能同时处理多少任务?这两个问题完全不同。四、GPU 不够的时候,不一定马上加 GPU这里还有一个很容易被忽略的问题。如果只是偶尔运行几个任务,简单地增加并发并不一定是最好的办法。例如:GPU │ ├── Agent 1 ├── Agent 2 ├── Agent 3 ├── Agent 4 └── Agent 5看起来很热闹。实际上可能所有 Agent 都在抢同一块 GPU。最后结果就是:CPU 看起来没满,GPU 也不一定 100%,但响应速度越来越慢。这种情况下,与其盲目增加 Agent 数量,不如先做任务调度。例如把任务分成:实时任务 │ ├── 用户交互 └── API 请求 后台任务 │ ├── 数据整理 ├── 文档总结 └── 批量分析 低优先级任务 │ ├── 索引构建 ├── embedding └── 定时任务实时任务优先。后台任务进入队列。低优先级任务错峰执行。很多时候,一个调度得当的 8 核服务器,比一个所有 Agent 同时抢资源的 16 核服务器更好用。五、真正应该控制的是“并发”,不是“Agent数量”这是我觉得部署多个 Agent 时最值得注意的一点。假设你有 20 个 Agent。并不代表应该让 20 个 Agent 同时执行。更合理的方式可能是: 20 个 Agent │ ▼ 任务队列 │ ┌─────────┼─────────┐ ▼ ▼ ▼ Worker 1 Worker 2 Worker 3 │ │ │ └─────────┼─────────┘ ▼ 模型服务比如服务器实际承受能力只有 5 个并发任务,那么就让其他任务排队。这样做的好处很直接:避免瞬时资源打满防止大量请求同时抢 GPU防止浏览器进程把内存吃光避免数据库连接突然暴涨防止 Agent 失败以后大量重试更容易控制任务优先级而且队列还有一个隐藏好处:它把“资源不足”从服务器崩溃,变成任务等待。这两个结果完全不是一回事。六、CPU 应该怎么估算?CPU 最容易被忽略。因为大家看到 AI,第一反应就是 GPU。但 Agent 并不是只有模型推理。下面这些事情都可能吃 CPU:Python 任务执行JSON 数据处理网页解析浏览器运行文件处理embeddingOCR音视频处理Docker 容器网络代理数据库操作如果是单纯的 API Agent,CPU 压力可能没那么明显。但是一旦加入浏览器和代码执行:Agent ├── LLM API ├── Browser ├── Python ├── Shell └── DockerCPU 就开始变成比较重要的资源。因此,与其问:“10 个 Agent 需要多少核?”不如先问:“这 10 个 Agent 同时会启动多少个真正消耗 CPU 的任务?”这才有意义。七、内存规划可以用一个很简单的方法如果你暂时没有完整的压测数据,可以先做一个粗略模型:服务器内存需求 ≈ 操作系统 + Agent运行时 + 数据库/Redis + 浏览器 + Docker + 模型相关内存 + 并发任务缓冲 + 安全余量最后再留一部分余量。不要把服务器规划成:16GB 内存,平时刚好用 15.8GB。这种配置短期可能没事。一旦某个 Agent 突然启动浏览器、加载大文件,或者模型上下文突然变长,OOM Killer 就可能出来“主持工作”了。实际部署时,我更倾向于让服务器保留一定余量。尤其是长期运行的服务。八、如果使用 vLLM,思路又不一样当你开始做更正式的模型服务,而不是简单本地跑一个模型时,vLLM 这种推理服务框架就会涉及更加细致的资源管理。例如 vLLM 提供 GPU memory utilization、KV Cache、最大活动序列数以及请求队列等配置,可以直接影响模型服务能够承载多少并发。当前文档中,--max-num-active-seqs 用于限制处于 RUNNING 状态的请求数量,而请求队列也可以通过相应参数设置上限。这时候资源规划就从:“我要一台什么配置的服务器?”变成了:“我要让这套模型服务稳定处理多少并发?”这已经是两个不同层级的问题。如果单 GPU 能够容纳模型,那么没必要为了“看起来高级”就直接上多机。vLLM 官方文档也把单 GPU、单机多 GPU、多机多 GPU 的场景进行了区分:模型能够放进单 GPU 时可以直接运行;单卡放不下但单机多卡可以容纳时,可以考虑 Tensor Parallel;模型连单机都放不下,再考虑多节点的 Tensor/Pipeline Parallel。所以:不要先买机器,再想怎么用。应该先确定模型、上下文、并发和延迟目标,再反推硬件。九、多个 Agent 最容易踩的一个坑:所有东西都塞在一台机器上刚开始玩的时候,一台 VPS 很舒服:VPS │ ├── Agent ├── Docker ├── Redis ├── PostgreSQL ├── Ollama ├── Nginx ├── Chromium └── 监控一个服务器全部搞定。但随着 Agent 数量增加,这种架构的问题会慢慢暴露出来。比如:Agent 跑崩了 → Docker 重启。Docker 重启 → 数据库受到影响。数据库负载高 → Agent 请求变慢。Agent 请求变慢 → 队列堆积。队列堆积 → 更多 Agent 重试。然后整个服务器一起开始冒烟。所以到了多个 Agent 阶段,最好开始考虑简单的资源隔离。比如: Gateway │ ┌─────┴─────┐ ▼ ▼ Agent Pool Agent Pool │ │ ▼ ▼ Worker Worker │ ┌─────┴─────┐ ▼ ▼ Redis Database │ ▼ Storage不一定非要一上来 Kubernetes。Docker Compose + 队列 + 基础监控,很多个人项目其实已经够用了。等任务规模真正起来,再考虑 Kubernetes、Ray 等更复杂的调度体系。十、什么时候应该加 CPU,什么时候应该加内存?可以简单粗暴地这么判断。CPU 经常 80%~100%优先检查:Agent 是否大量执行代码是否大量使用浏览器是否存在 OCR / embedding / 数据处理是否有任务同时启动是否存在死循环或者异常重试这种情况下优先考虑增加 CPU 或降低并发。内存经常接近上限重点检查:浏览器数量Agent Runtime 数量Docker 容器数据库缓存上下文长度本地模型是否存在内存泄漏这种情况下加内存通常比加 CPU 更直接。GPU 显存爆掉先不要急着买更大的 GPU。先确认:模型到底多大quantization 是否合理context length 是多少并发是多少KV Cache 占了多少是否同时加载多个模型因为有时候不是模型太大。而是:你让它同时干的事情太多了。十一、一个比较实用的资源规划表如果只是做个人项目,可以先按照这个思路估:场景CPU内存GPU主要瓶颈2~3 个 API Agent2~4 核4~8GB不需要网络/任务调度5~10 个轻量 Agent4~8 核8~16GB不需要RAM/并发多个浏览器 Agent8~16 核16~32GB不一定RAM/CPU本地小模型 + 多 Agent8 核+16~32GB视模型而定VRAM本地模型 + 较高并发8~16 核+32GB+多 GPU 视模型而定VRAM/KV Cache多模型/大规模推理16 核+32GB+多 GPUGPU/网络/调度这张表只能作为起步估算,不能替代实际压测。尤其是 AI Agent,差异实在太大。同样叫“10 个 Agent”,有可能一个只调用 API,另一个却同时开 10 个浏览器、执行代码和处理文档。两者的服务器需求可能完全不是一个量级。十二、我更推荐的思路:先把 Agent 当成“任务”,而不是“进程”这是整个问题里我认为最重要的一点。如果把 Agent 理解成一个长期运行的进程:“我要 10 个 Agent,所以我要 10 份资源。”资源很容易越堆越大。但如果把 Agent 理解成:一个可以被调度的任务执行单元。思路就会完全不一样。你可以让:Agent数量:20 Worker数量:5 最大并发:5 任务队列:10020 个 Agent 可以存在。但任何时候只有 5 个任务真正占用计算资源。当某个任务结束以后,再把下一个任务交给 Worker。这样服务器的资源利用率会更加可控。最后:别先问“需要多大的服务器”如果只是跑一个 AI Agent,这个问题其实很简单。但当你开始同时运行 5 个、10 个甚至几十个 Agent 后,真正需要考虑的是:模型是什么?并发是多少?上下文多长?有没有浏览器?有没有代码执行?是不是本地模型?任务是不是长期运行?能不能接受排队?这些因素加起来,才决定最终的服务器配置。尤其是本地模型服务,GPU 显存并不是唯一指标。并发请求、KV Cache、上下文长度以及服务端调度都会影响实际吞吐。像 vLLM 这样的推理框架已经把这些问题做成了比较明确的调度和资源控制参数。所以如果你现在正准备搭一套自己的 AI Agent 环境,我反而建议:先跑起来,再压测,再扩容。不要一开始就为了“以后可能有几十个 Agent”买一台巨型服务器。从一个可观测、可限制并发的环境开始,记录 CPU、RAM、GPU、显存、请求延迟和任务队列长度。等数据出来以后,你自然就知道下一步应该加 CPU、加内存、加 GPU,还是单纯把任务调度做好。这比看着服务器配置表猜,靠谱得多。
-
如何看待当下的AI挖洞?AI挖洞有没有前途 这两年做渗透测试、漏洞挖掘的人,应该都有一个越来越明显的感觉:AI 真的开始进场了。以前我们说“AI 挖洞”,多少还有点像一个概念。让大模型帮你分析代码、看看请求、解释一个漏洞,这些事情早就能做。但真到了 2025、2026 年,情况已经开始不一样了。现在的 AI 不只是“帮你写 Payload”。它开始自己读代码、分析程序、调用工具、运行测试、验证漏洞,甚至尝试修改补丁。所以很多刚入行的人会开始问一个很现实的问题:以后还需要学渗透测试吗? AI 都能自己挖漏洞了,人还有什么价值?我的看法是:AI 挖洞肯定有前途,而且这个方向已经不是“有没有前途”的问题了,而是它已经开始成为漏洞研究的一部分。但另一件事也是真的:现在就说“以后 AI 可以完全替代渗透测试人员”,还早。一、先别急着说“AI 要取代黑客”,现在它已经能干什么?先看几个比较实际的变化。DARPA 的 AI Cyber Challenge(AIxCC)本身就是一个很典型的例子。这个项目专门研究利用 AI 自动发现、分析和修复软件漏洞。在 2024 年的半决赛中,参赛系统发现了 22 个独特的人工植入漏洞,并修复了其中 15 个,同时还发现过 SQLite 中的真实世界漏洞。到 2025 年的最终竞赛,AI 系统已经被要求在更复杂的软件环境里同时完成漏洞发现和修复。这说明一个问题:AI 挖漏洞已经不是 PPT 里的概念了。Google 这边也在做类似的事情。Google DeepMind / Project Zero 的 Big Sleep 已经被用于漏洞发现,Google 在 2025 年公开表示,它曾发现包括 SQLite 在内的真实世界漏洞;到 2026 年,Google 又表示已经把基于 Gemini 的 agent harness 扩展到了更大范围的 Chrome 代码库。OpenAI 也已经推出了 Codex Security research preview,用 agent 去理解项目上下文、寻找复杂漏洞、验证结果,并尝试生成修复方案。所以现在再说:“AI 只能写写代码,根本不会真正挖漏洞。”这个判断已经站不住了。二、但是 AI 挖洞和我们理解的“挖洞”,其实不是一回事很多人第一次接触 AI 挖洞,会产生一个误解:给 AI 一个网站。 然后 AI 自己扫描。 找到漏洞。 自动验证。 最后提交报告。如果真能稳定做到这个程度,那确实非常吓人。但现实距离这个状态还有明显差距。因为真正的漏洞研究,往往不是:“这里有没有漏洞?”而是:“这个功能到底是怎么工作的?”这两个问题完全不一样。举个很简单的例子。一个普通的 IDOR,你可能一眼就能发现:代码语言:javascriptAI代码解释/user/profile?id=1001改成:代码语言:javascriptAI代码解释/user/profile?id=1002然后看返回结果。这属于比较典型的自动化任务。但如果开发人员做了三层权限判断:代码语言:javascriptAI代码解释前端权限 ↓ API 权限 ↓ 业务对象权限而真正的问题出现在第三层。这时候就不是简单改个 ID 能解决的。你需要理解:用户角色之间有什么区别;对象属于谁;服务端到底在哪一步做权限判断;哪些接口共享同一个业务对象;某个状态变化之后权限模型有没有发生变化。这时候真正值钱的其实不是“会不会发请求”。而是:你有没有能力建立业务模型。三、AI 现在最强的地方,其实不是“发现神洞”,而是“扩大搜索面积”这一点我觉得特别重要。很多人讨论 AI 挖洞,总喜欢拿“AI 能不能发现一个超级复杂 0day”来判断它有没有价值。其实这个角度有点偏。AI 最大的优势可能根本不是:一次挖出别人十年没发现的神级漏洞。而是:以前一个人只能看 10 万行代码,现在可以让几十个 agent 同时帮你分析。这才是真正恐怖的地方。人类的问题是什么?时间有限。精力有限。注意力有限。一个研究员一天可能认真分析几个模块。但是机器可以同时跑大量任务。比如:代码语言:javascriptAI代码解释代码审计 ↓ 自动定位高风险函数 ↓ 生成测试用例 ↓ 尝试构造输入 ↓ 运行程序 ↓ 观察异常 ↓ 再次调整输入 ↓ 验证漏洞这个过程如果全部交给人工,成本非常高。但 AI Agent 可以把大量重复劳动吃掉。所以以后非常可能出现一种情况:不是 AI 替代漏洞研究员,而是“一个漏洞研究员 + 一堆 AI Agent”。一个人带着十个、二十个甚至更多自动化研究任务同时跑。这才是我觉得比较现实的未来。四、AI 挖洞真正的问题,其实是“误报”这个问题很多宣传文章不会重点讲。因为“AI 一晚上发现 5000 个漏洞”听起来很夸张。但你真正把结果打开:代码语言:javascriptAI代码解释Finding 0001 Finding 0002 Finding 0003 Finding 0004 ...然后发现:其中一大堆根本没法利用。还有一些:重复漏洞。再有一些:只是理论风险,实际攻击链根本走不通。这就麻烦了。HackerOne 在 2026 年公开讨论过这个问题:随着 AI 能力增强,漏洞报告数量明显上升,但增加的报告并不全部具有同等价值,其中会包含重复、无法验证、缺乏足够技术深度的提交。其平台 2026 年 3 月的报告量达到 46,947 份,同比增长 76%,而确认可利用的比例大约仍在四分之一左右。所以:发现 1000 个结果,不等于发现 1000 个漏洞。真正重要的是:代码语言:javascriptAI代码解释发现 ↓ 验证 ↓ 利用 ↓ 判断影响 ↓ 去重 ↓ 形成完整漏洞链 ↓ 写出别人能复现的报告最后这几步,目前仍然非常依赖人的判断。五、还有一个 AI 不太容易处理的问题:业务逻辑这个可能是我最看好的一个方向。因为很多漏洞并不是代码层面那种特别标准的:代码语言:javascriptAI代码解释SQL Injection XSS RCE SSRF而是:业务设计本身有问题。例如:一个平台正常流程是:代码语言:javascriptAI代码解释注册账号 ↓ 购买商品 ↓ 支付 ↓ 生成订单 ↓ 获得权益结果你研究半天发现:代码语言:javascriptAI代码解释优惠券校验在 A 接口 订单价格校验在 B 接口 最终权益发放在 C 接口然后 A、B、C 三个接口分别看起来都没什么问题。但是组合起来:就出问题了。这种漏洞特别依赖研究员自己的理解。你需要站到业务设计者的角度去想:“如果我是开发,这三个接口为什么这样设计?”然后再反过来找:“有没有哪一个状态,可以被我人为制造出来?”这类东西,确实是 AI 很想攻克、但目前仍然比较困难的地方。六、所以以后还值得学 Web 漏洞吗?我觉得更应该学。只是学习方式要变。以前可能是:代码语言:javascriptAI代码解释学 HTTP ↓ 学 Web 漏洞 ↓ 学 Burp ↓ 学扫描器 ↓ 刷靶场 ↓ 找漏洞以后更合理的路线应该是:代码语言:javascriptAI代码解释理解 Web 原理 ↓ 理解漏洞原理 ↓ 学会人工验证 ↓ 学会代码审计 ↓ 学会使用 AI ↓ 学会编排 Agent ↓ 人工 + AI 联合研究也就是说:以后最危险的不是“不会 AI 的安全人员”。真正容易被淘汰的,反而可能是:只会机械执行固定流程的人。比如:代码语言:javascriptAI代码解释打开 Burp ↓ 扫目录 ↓ 跑扫描器 ↓ 复制结果 ↓ 提交报告这一整套工作,本身就特别适合自动化。AI 只是让这个自动化过程进一步升级。七、那“AI 挖洞”到底有没有前途?如果你问我的判断:有,而且会越来越重要。但我不建议把它理解成:“以后 AI 自己挖洞,人就不用学了。”我反而更倾向于认为,未来会出现一种新的漏洞研究模式:代码语言:javascriptAI代码解释人 │ ├── 定义目标 ├── 理解业务 ├── 提出假设 ├── 设计攻击思路 └── 判断最终影响 │ ▼ AI Agent │ ┌──────┼──────┐ ▼ ▼ ▼ 代码审计 测试 验证 │ │ │ └──────┼──────┘ ▼ 人工复核 ▼ 最终结论AI负责大量重复工作。人负责真正困难的判断。这个分工,我觉得反而非常合理。八、以后什么样的人更吃香?这个问题其实比“AI 有没有前途”更值得问。如果一个人现在只会:“这个参数可能存在 SQL 注入,我用一下工具。”那确实会越来越卷。但是如果你能够做到:“我理解这个系统的业务逻辑,我知道它的数据怎么流动,我可以根据异常行为提出假设,再让 AI 帮我快速验证。”那完全是另外一个层级。未来真正有价值的能力,我觉得会逐渐向这几个方向集中:第一,漏洞原理。不是背 Payload。而是知道为什么这个 Payload 能成功。第二,代码理解。至少要能够读懂常见的 Web 后端逻辑。第三,业务理解。尤其是支付、权限、订单、身份、云服务这些复杂系统。第四,AI 使用能力。不是简单问 ChatGPT:“帮我找一下这个漏洞。”而是能够让 AI 成为你的研究助手。第五,验证能力。AI 说有漏洞,不代表真的有。你得自己证明。这一点以后可能反而越来越重要。九、最后说一个可能不太好听的事实AI 对漏洞挖掘最大的改变,可能不是:“以后 AI 会不会挖洞。”而是:“漏洞的产能可能会突然提高很多。”过去一个研究员一天能分析多少东西,有比较明显的上限。以后这个上限可能会被 AI 大幅度提高。于是问题就会从:“谁能找到漏洞?”慢慢变成:“谁能在海量自动化结果里找到真正有价值的漏洞?”这其实又回到了人的能力。你看得懂代码吗?你理解业务吗?你能判断攻击链吗?你能区分一个普通低风险问题和一个真正有影响的漏洞吗?你能让 AI 按照你的思路去工作吗?这些东西,才可能是未来几年真正拉开差距的地方。写在最后所以对于现在还在学渗透测试、漏洞挖掘的人,我反而不建议因为 AI 出现就开始焦虑。真正应该警惕的是另一件事情:还在用几年前的方式学习。以前我们可能花大量时间记工具参数、背 Payload、刷重复靶场。以后这些东西依然有用,但它们的边际价值可能会越来越低。真正值钱的,是你脑子里那套:发现问题 → 提出假设 → 验证假设 → 建立攻击链 → 判断影响AI 可以帮你把前面的路跑得更快。但最后那个“为什么这个系统会出问题”,依然需要有人真正想明白。所以 AI 挖洞有没有前途?答案其实已经不是一个未来时。它已经开始发生了。现在真正值得考虑的问题应该变成:当 AI 开始参与漏洞研究以后,你想成为被 AI 替代的人,还是使用 AI 的那个人?这个选择,可能比“AI 会不会挖洞”本身重要得多。
-
-
AI-Infra-Guard-腾讯朱雀开源AI红队平台 近期,不管是公司这一方面还是个人那一块,都如同着了魔一般地去构建AI应用。在本地进行Ollama的部署来运行DeepSeek,运用ComfyUI来开展绘图工作,利用vLLM来作为推理服务,在Dify以及Coze上进行拖拖拽拽的操作来搭建工作流,MCP Server也承接了不少相关事务。我周边搞开发的朋友,十个当中有八个在做这些个事情。但很少有人问一句:你搭的这些东西,安全吗?今年2月份朱雀实验室发过一个预警,说很多人本地部署的Ollama、DeepSeek这些开源AI工具,都带着默认配置漏洞,公网一开攻击者直接就能拿服务器。问题是知道有问题又能怎么样?总不能自己对着CVE列表一个个去核对吧?腾讯朱雀实验室将他们自身所使用的AI红队平台予以开源,此平台被称作AI-Infra-Guard,简称为A.I.G。该项目还成功入选了Black Hat Europe 2025 Arsenal。GitHub:https://github.com/Tencent/AI-Infra-Guard直白来讲,这个玩意儿就是专门用来给AI系统做安全方面检查的。以前是用Nessus去扫描服务器的漏洞,用Nmap去扫描端口,而A.I.G扫描的是AI的基础设施。它可不是那种写几个正则来匹配CVE编号的简单脚本,它从底层的模型服务,到中间的Agent工作流,再到上层的MCP插件,一层一层地给你进行检测。腾讯安全平台部于2019年成立了朱雀实验室。朱雀实验室曾经协助NVIDIA、Google、微软等厂商以及OpenClaw、Hugging Face等开源社区发掘了相当多的高危漏洞。朱雀实验室在Black Hat、DEF CON等会议上发表过论文,并且还出版过《AI安全:技术与实践》这一本书籍。朱雀实验室并非是那种去蹭AI热度的草台性质的项目。在GitHub上面存在着四千多颗星。更新的情况还算是比较频繁的。到了2026年6月份的时候还在连续地发布版本。来瞧瞧用户的列表吧,腾讯它自己、DeepSeek、工行、招行、vivo、OPPO、B站,就连蜜雪冰城都在进行使用。目前A.I.G集成了五个主要功能,基本把AI系统能出问题的地方都覆盖了:AI 基础设施漏洞扫描属于基础的功能。它可以对 100多种 AI 组件的指纹进行识别,能够匹配 1900多个 已知的 CVE。像 vLLM、Ollama、llama.cpp 这类推理引擎,Gradio、LangChain、Streamlit 这类开发框架,ComfyUI、n8n、Dify、Coze 这类应用平台,还有 ClickHouse 这类组件都可以被它识别到。在使用的时候输入 IP 或者域名,它自己进行识别版本、匹配漏洞库,之后直接就告诉你哪个组件存在什么漏洞、严重程度是如何、该怎么进行修复。接下来对于MCP Server和Agent Skill进行安全扫描。MCP当下已经成为AI Agent生态的实际标准,但是同时也是新的攻击重点区域。A.I.G可以检测14大类MCP安全风险,其中包含指令劫持、记忆投毒,还有远程代码执行、权限提升、依赖投毒这类常见问题。无论是扫描源码还是扫描远程URL都可以,不需要运行服务就能够检测。存在一个多Agent自动化红队扫描框架。此框架是专门用于对Agent工作流的安全性进行测试的。Dify以及Coze上运行着的Agent都能够接入进来进行测试。它会自动去查找越权、数据泄露、工具滥用这类相关的问题。如同给你的Agent免费聘请了一个红队来进行检查一样。大模型有关于越狱评估的相关状况。它内部内置了好几组越狱测试数据集。它会运用各种各样的方式去尝试突破你的模型。它还能够支持多个模型来进行横向的对比,直接就可以告知你哪一个模型更加难以被越狱。要是你去运用OpenClaw生态系统,直接安装“aig-scanner”这一功能模块便能够一键进行扫描操作,而无需单独地去部署整个平台体系 。界面是现代化Web UI,支持中文。Docker一键部署,4G内存、10G磁盘就能跑:在左侧的菜单当中去点击相对应的功能,然后填入目标地址便能够开始进行扫描,进度将会实时地进行显示,最终会生成可视化的报告,在这个报告里面有漏洞的详细情况、风险的等级评定、修复的相关建议,并且还可以进行导出操作。部署方式有三种,最快的是用预构建Docker镜像:Git clone https://github.com/Tencent/AI-Infra-Guard.git cd AI-Infra-Guard Docker-compose -f Docker-compose.images.yml up -d懒人的话直接用一键脚本:curl https://raw.githubusercontent.com/Tencent/AI-Infra-Guard/refs/heads/main/docker.sh | bash对该文章进行如下较为随意且存在表述问题的改写:访问了网址为http://localhost:8088的网站。默认的账号和密码那就是admin以及admin。进入到里面之后,得要记住去修改密码。如果只是想快速扫单个目标,不用部署Web服务,直接下二进制文件命令行跑就行:# 单个目标 ./ai-infra-guard -target http://127.0.0.1:11434 # 扫多个 ./ai-infra-guard -target 192.168.1.100 -target example.com # 加AI分析,让混元大模型给你出修复建议 ./ai-infra-guard -target http://127.0.0.1:8000 -ai -token your-token做CI/CD集成的话,还有个 aig-skill-scan 的Python包,pip装完就能在流水线里跑Skill安全审计:pip install aig-skill-scan export LLM_API_KEY="your-api-key" aig-skill-scan --repo /path/to/skill -m deepseek-v4-flash -o result.json我为什么推荐这个项目?首先来讲讲靠谱这回事。腾讯朱雀实验室所搞的这个东西,在Black Hat上面登台讲过,而且是大厂都在使用的,可不是那种个人开发者随随便便弄来玩玩的项目。再就是真的很全面,从底层的CVE到上层的MCP风险,还有Agent安全以及越狱测试,把AI安全的主要方面全都涵盖进去,不用你东拼西凑好几个工具。更新的速度还很快,我看到6月份还在更新,刚刚又加了39个新的AI组件指纹、600多条CVE规则,这样的项目才敢用在生产环境当中。首先得是好用的。WebUI操作比较简单,点那么几下就可以进行扫描。界面是中文的,不用你去编写一大堆的配置文件。有完整的API,还能够当作Skill直接安装到Agent里面去,对于DevSecOps是挺友好的。它是遵循Apache 2.0协议开源的,商业方面使用也没有问题,还可以自己添加规则插件。当下人工智能安全的情形确实有些可笑。所有人都急切地将人工智能往生产环境中推进,全然没有人去关注安全这件事情。这如同在2000年初的时候大家疯狂地建设网站,没有人去管SQL注入、XSS这些问题是一样的情况。等到出现了被拖库、被挖矿、数据泄露这些状况才想着去进行补救,到那个时候就已经晚了。不要等到出现问题了才去采取行动。花上三分钟的时间来对A.I.G进行设置,对您所运行着的很多人工智能应用做一番检查,这并没有什么不妥的地方。注:禁止对未授权的目标进行渗透测试GitHub地址:https://github.com/Tencent/AI-Infra-Guard