搜索到
186
篇与
的结果
-
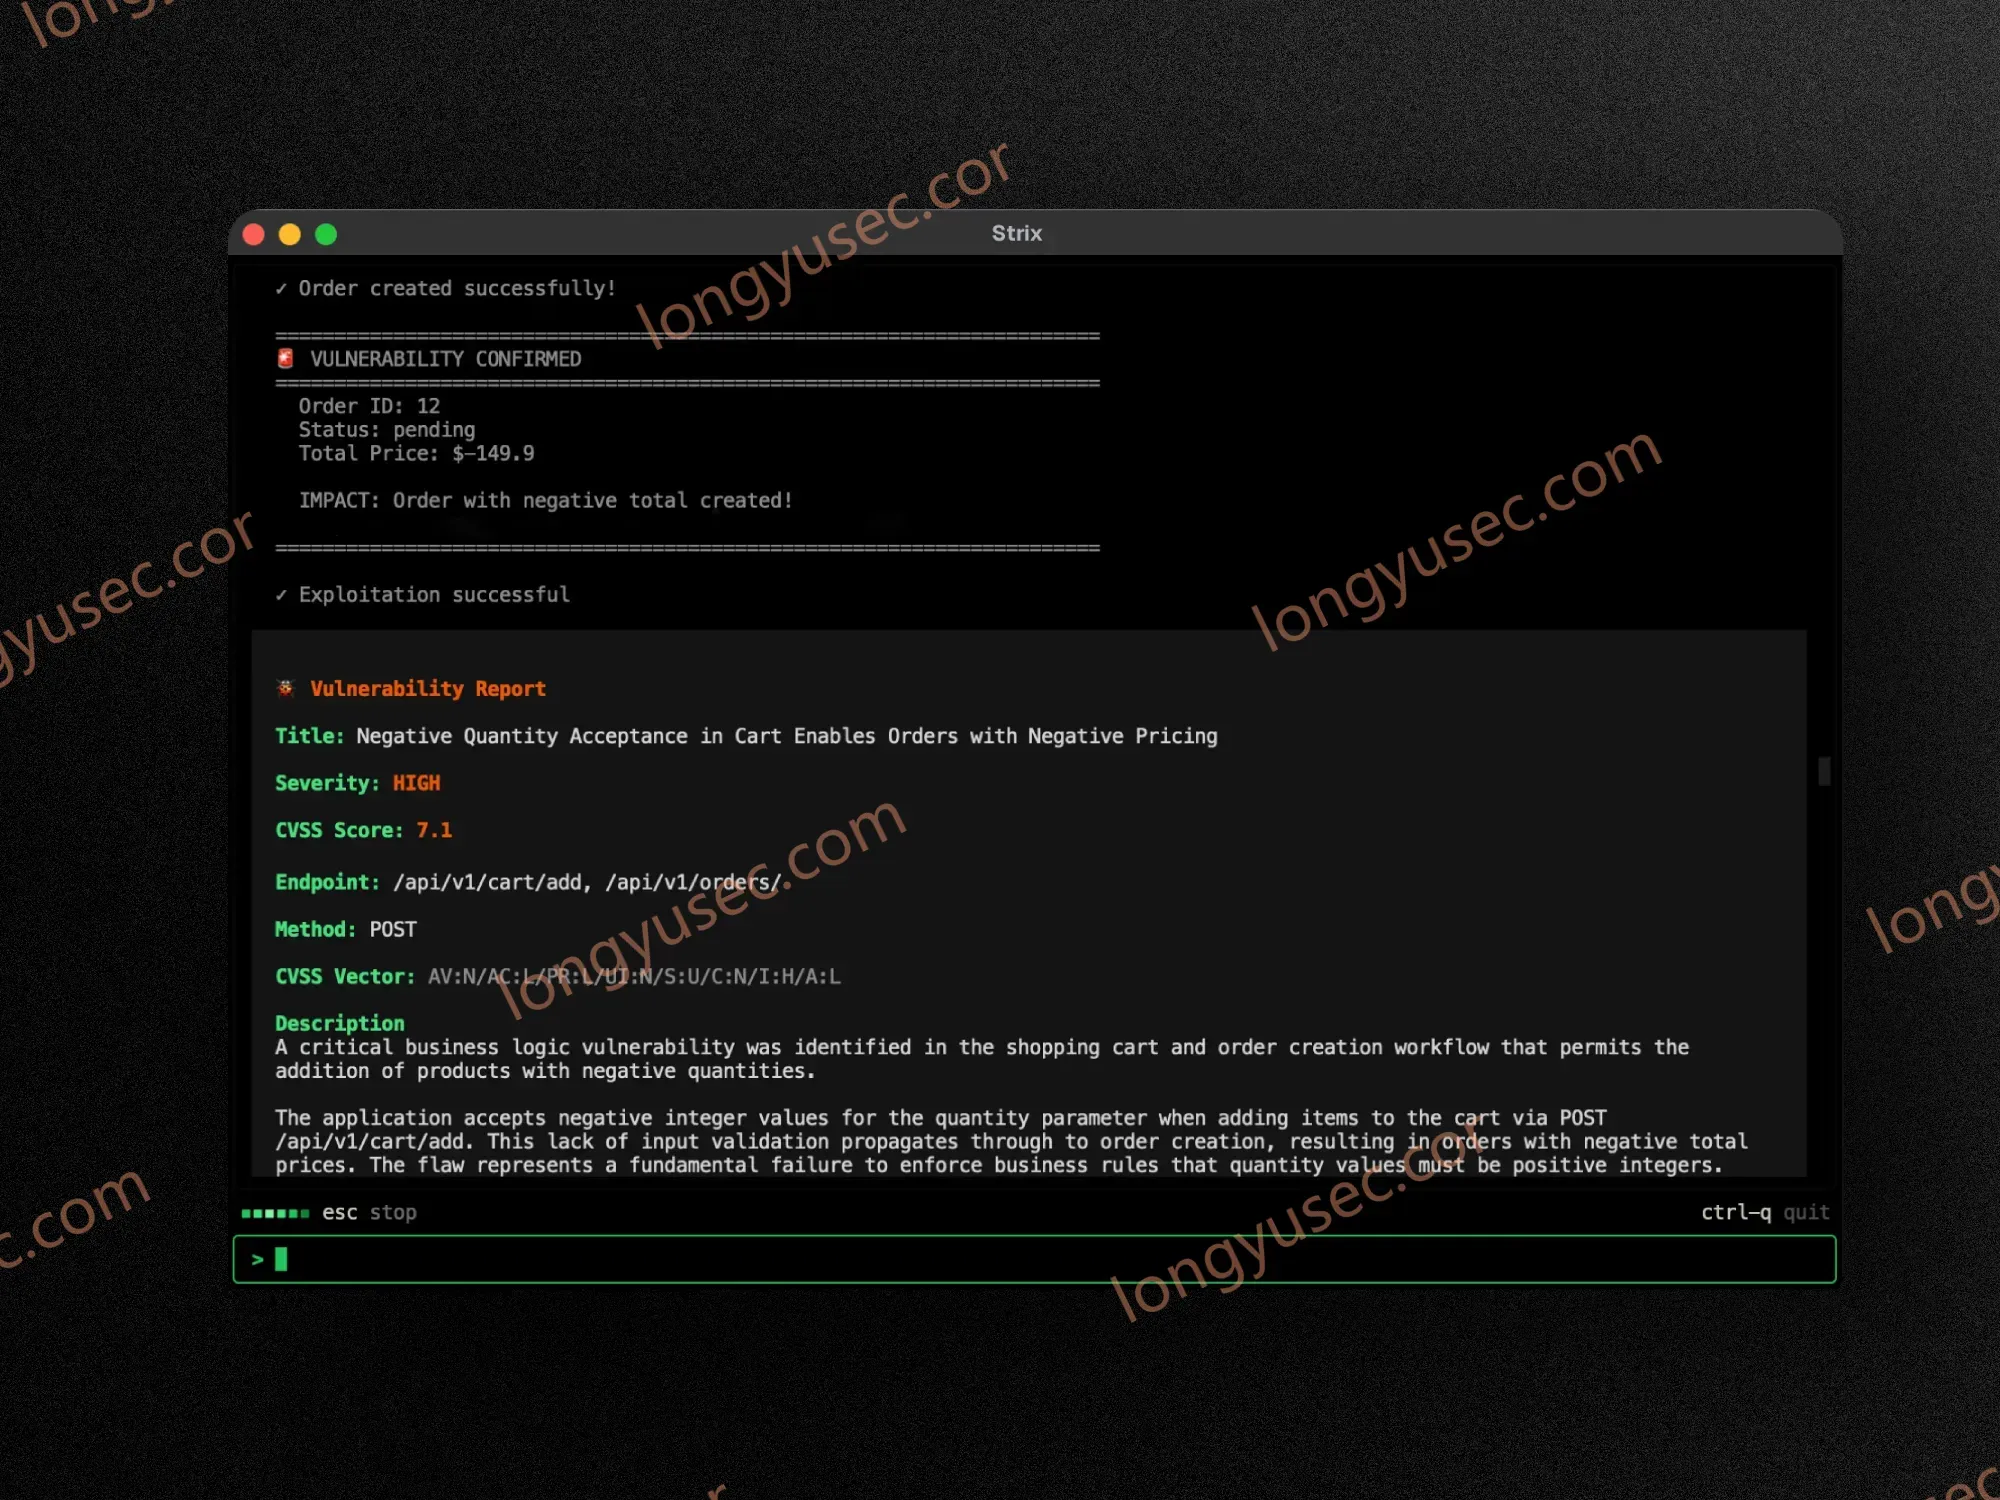
 AutoCVE-一周30个CVE:这个Agent把CVE挖掘全流程自动化了 依靠手工去寻找CVE到底会有多么的困难?很多曾经有过相关经历去做过这件事的人内心之中都是非常清楚的很。筛选项目,寻觅开源仓库,对环境进行配置来运行SAST,手动去过滤很多误报情况,从Sink往回追溯SouRCE来分析数据流,撰写PoC来进行验证,整理英文方面的报告……这样一套流程走下来,短的时候是几天长的时候是几周,大部分的时间都花费在重复的劳动上面,留给思考的时间没有多少。最近我瞧见有一个刚刚发布出来的开源项目叫做 AutoCVE。该项目的作者,把CVE挖掘的那一系列的流程都交托给Agent去自动化地进行操作。这流程包含了选项目、导仓库、审代码、验漏洞、写报告这类步骤。这并非是 PPT 形式的项目。官方进行的测试是一周时间,并且是全自动运行的,获取到了 30 个 CVE 编号,还涉及 14 个开源项目。最高的 CVSS 评分达到了 9.9 ,整个过程可是完全没有人工干预的。在发布两周之后,GitHub 上的星数就突破了 1000 。它到底做了什么?AutoCVE并非是那种将代码随便扔给大模型进行胡乱聊天的套壳类型的项目。它是专门为CVE挖掘场景所设计的 Multi-Agent 审计平台。它具备完整的产品界面、工作流编排、沙箱隔离、工具权限控制这些东西。它进行了好多工程上面的优化,来解决LLM审计发散、不收敛、乱报漏洞这类的问题。整个流程是处于全自动化的状态。从项目的筛选起始,随后是仓库的导入,之后开展创建审计任务的操作,再之后实施Agent漏洞挖掘的行为,最终生成CVE申报报告。用户将报告的内容进行复制下来之后提交上去,便可以完成后续的CVE申请事宜。自动进行筛选项目的操作。你仅仅需要告知它需要挖掘多少个CVE,它自身就会从GitHub上面去寻找适合进行审计的开源项目。自动地将代码导入到仓库之中,接着自动地把代码拉取到本地的工作区域当中。依据项目的规模情况以及相应的配置状况去进行审计模式的选取,随后自动地开展审计任务的创建。存在着 5个专职的Agent 来开展多Agent协同审计工作,此5个Agent分别有着不一样的分工情况,并且各自去履行其自身所承担的职责。于沙箱之内运行PoC以动态验证漏洞,与此同时将误报状况予以过滤掉。自动地生成那CVE的报告,输出那种符合CVE申报格式的报告,能够进行复制粘贴然后提交。用户首先需要将模型进行配置操作完毕,随后便等待模型运行结束,紧接着把报告进行复制的动作完成,之后进行CVE的提交操作,这样就视为完成了相关的一系列流程。5个Agent怎么分工?通过Orchestrator统一调度Recon、Scan、Triage、Finding和Verification等Agent,协同完成信息收集、工具扫描、误报过滤、漏洞深挖与动态验证:整个工作流由Orchestrator统一调度,每个Agent只干自己擅长的事:Recon(侦察):分析项目情况——什么语言、什么框架、入口文件在哪、哪些路径优先审计Scan(扫描):调用Semgrep、Bandit这些现成SAST工具先跑一轮规则扫描Triage(分诊):对Scan出来的结果做人工复核,把明显误报过滤掉,补充证据Finding(挖掘):核心审计Agent,通过源码追数据流,构造攻击链,挖高价值0dayVerification(验证):在Docker沙箱里动态运行PoC,验证漏洞是否真的能打,不靠猜AutoCVE当前支持 三种审计模式,可根据不同的审计目标选择:交互式审计与全过程追踪AutoCVE拥有着完备的交互能力。那完整的审计过程会被视作会话的上下文。用户可以围绕着审计的结果继续进行追问,让Agent去补充证据、去解释攻击链、去完善复现的步骤又或者是去扩展漏洞的分析 。可以展开查看每个工具调用的详细信息:输入$便可以显示出来并且调用相应的Skill。要是没有指定模型的话,系统会根据任务自动去匹配合适的Skill 。可视化审计追踪模块集中展示活动日志、Agent Tree、工具调用、阶段进度、初步报告和审计会话,方便复盘每次审计的执行路径与关键过程:智能化漏洞管理审计发现的漏洞由Agent调用工具自动提交,经过去重后以结构化形式入库,并在漏洞管理模块中统一维护:AutoCVE的漏洞报告会由Agent自动结构化生成,包含Summary、DetAIls、PoC、Impact、Remediation、Disclosure Notes、Affected products、CVSS、CWE、Suggested CVE description等字段,可复制用于从GitHub Advisory提交漏洞报告:还支持根据实际需求为不同Agent配置专属Skills,灵活扩展各Agent的能力边界:实际成果:一周30个CVE说再多不如看战果。官方一周测试,全自动跑下来共拿到 30个CVE,覆盖的都是真实有用户量的开源项目,不是靶场。CVE编号项目漏洞类型CVSSCVE-2026-48765typebot.io授权绕过9.9CVE-2026-43986TautulliSSRF9.9CVE-2026-43984Tautulli存储型XSS8.9CVE-2026-43985TautulliCSRF8.8CVE-2026-41235froxlor授权错误8.8CVE-2026-46372SillyTavernSSRF8.5CVE-2026-48763typebot.io权限缺失8.2CVE-2026-48764typebot.ioSSRF8.2CVE-2026-40904Chartbrew越权访问8.1CVE-2026-40600Chartbrew越权访问8.1CVE-2026-45260pimcore权限缺失8.1...还有19个SQL注入/RCE/硬编码密钥等3.7-8.1涉及的项目包含 xxl-job、JeecgBoot、o2oa、Lemmy、Chartbrew、BentoML、typebot.io、OpenReplay、SillyTavern、pimcore、froxlor、Tautulli、filebrowser、craftcms —— 14个项目,其中不少是数万Star的热门项目。部署和使用部署非常简单,一行Docker命令搞定,不需要自己搭环境:# Linux/macOS/Git Bash curl -fsSL https://raw.githubusercontent.com/larlarua/AutoCVE/v1.0.5/docker-compose.prod.yml | Docker compose -f - up -dWindows PowerShell/CMD也一样:curl.exe -fsSL https://raw.githubusercontent.com/larlarua/AutoCVE/v1.0.5/docker-compose.prod.yml | Docker compose -f - up -d启动完访问:前端界面:http://localhost:3000API文档:http://localhost:8000/docs流程实际上是挺简单的。首要的是配置你那个 LLM API Key ,它能够支持比如 OpenAI、DeepSeek 等各式各样的模型。随后可以挑选导入项目,或者开启一键 CVE 这个功能。紧接着就是等着 Agent 把流程给跑完。再之后到漏洞管理那边去查看相应的结果。最后导出报告并且提交 CVE 。一点感受AI代码审计并非是什么全新的事物。以往存在着不少类似的项目。但是大多数要么仅仅处于demo的水平,拿不上台面,要么就是弄一个空壳子来调用API,要是真的想要挖掘漏洞还是得依靠人去进行操作。AutoCVE比较难得的地方在于它是真真正正从产出CVE这个目标往回倒推来进行工程化打造的产品,并非是为了展示AI而去弄AI。多Agent分工、Triage过滤误报、Verification沙箱验证、Nudge纠偏、结构化输出这些细节方面,是实际运用LLM去审计代码的时候会碰到的坑,作者都想到了而且还给出了解决的办法。30个真实CVE的战果便是最好的证明——这玩意儿确实能挖出漏洞来。它并非是用来取代安全研究员的。恰恰相反——它将人从筛项目、跑工具、写报告这类重复劳动中解放出来,让人把精力投放到真正需要思考的复杂漏洞逻辑上去。对于很多想要去挖掘CVE但是效率比较低的人,又或者企业里很多要进行批量审计开源组件的团队而言,这个工具是值得去尝试一下的。项目地址GitHub:https://github.com/larlarua/AutoCVE项目才刚刚推出了v1.0.5版本,还在不断地快速进行更新迭代。要是你对它感兴趣的话,那就可以到上面去点一个Star、提出一个Issue相关的,或者自己把它运行起来,去尝试着找找CVE 。⚠️ 重要提醒:工具仅可用于授权安全研究,绝对禁止在未授权情况下扫描他人系统。提交漏洞时请遵循负责任披露规范。服务器推荐
-
-
-
Python很慢?这十个方法让你的代码执行速度提升3倍! 前言Python,作为一种动态类型的解释性语言,确实在执行速度上可能不如C这样的静态类型的编译语言。但是,通过一些技巧和策略,我们可以显著提升Python代码的性能。本文将探讨如何通过优化方法使Python代码运行得更快、更高效。我们将利用Python的timeit模块来精确测量代码的执行时间。注意:timeit模块在默认情况下会重复执行代码一百万次,以确保测量结果的准确性和稳定性def print_hi(name): print(f'Hi, {name}') if __name__ == '__main__': # 执行print_hi('PyCharm')方法 t = timeit.Timer(setup='from __main__ import print_hi', stmt='print_hi("PyCharm")') t.timeit()如何计算Python脚本的运行时间呢?在time模块中time.perf_counter()提供了一个高精度的计时器,适合测量短时间,例如import time # 记录程序开始时间 start_time = time.perf_counter() # 你的代码逻辑 # ... # 记录程序结束时间 end_time = time.perf_counter() # 计算程序运行时间 run_time = end_time - start_time print(f"程序运行时间:{run_time} 秒")介绍一、I/O密集型操作I/O密集型操作(Input/Output Intensive Operation)指的是那些在执行过程中,大部分时间都花在等待输入/输出操作完成的程序或任务。I/O操作包括从磁盘读取数据、写入数据到磁盘、网络通信等。这些操作通常涉及到硬件设备,因此它们的执行速度受到硬件性能和I/O带宽的限制。他们的特点有:\1. 等待时间:程序在执行I/O操作时,往往需要等待数据从外部设备传输到内存,或从内存传输到外部设备,这会导致程序的执行被阻塞。\2. CPU利用效率:由于I/O操作的等待时间,CPU在这段时间内可能处于空闲状态,导致CPU利用率不高。\3. 性能瓶颈:I/O操作的速度往往成为程序性能的瓶颈,尤其是在数据量大或传输速度慢的情况下。例如,使用I/O密集型操作print,运行一百万次import time import timeit def print_hi(name): print(f'Hi, {name}') return if __name__ == '__main__': start_time = time.perf_counter() # 执行print_hi('PyCharm')方法 t = timeit.Timer(setup='from __main__ import print_hi', stmt='print_hi("PyCharm")') t.timeit() end_time = time.perf_counter() run_time = end_time - start_time print(f"程序运行时间:{run_time} 秒")运行结果为3s而不使用i/o操作执行一个方法,即调用这个print_hi('xxxx')空方法,不使用print(),程序明显快了不少def print_hi(name): # print(f'Hi, {name}') return如果代码中必要的时候,例如文件读写,可以使用如下方法提高效率异步I/O:使用异步编程模式例如asyncio,允许程序在等待I/O操作完成时继续执行其他任务,从而提高CPU利用率。缓冲:使用缓冲区暂存数据,减少I/O操作的频率。并行处理:并行执行多个I/O操作,以提高整体的数据处理速度。优化数据结构:选择合适的数据结构,减少数据的读取和写入次数。二、使用生成器生成列表、字典在Python 2.7及其后续版本中,引入了对列表、字典和集合生成器的改进,这些改进让数据结构的构建过程更加简明和高效。1、传统方法def fun1(): list=[] for i in range(100): list.append(i) if __name__ == '__main__': start_time = time.perf_counter() t = timeit.Timer(setup='from __main__ import fun1', stmt='fun1()') t.timeit() end_time = time.perf_counter() run_time = end_time - start_time print(f"程序运行时间:{run_time} 秒") # 输出结果:程序运行时间:3.3872999000595883 秒2、使用生成器优化代码注:为了方便以下内容皆省略主函数main的代码部分def fun1(): list=[ i for i in range(100)] # 程序运行时间:2.1053185999626294 秒从上述的推导式程序中可以看出,除了理解更简洁、更容易阅读之外,它也更快。这使得此方法成为生成列表和循环的首选方法。三、避免字符串连接,使用join()join() 是一个字符串方法,在Python中用于将序列中的元素连接(或拼接)成一个字符串,通常使用特定的分隔符。他的优点通常为:\1. 效率高:join() 是连接字符串的高效方法,尤其是当处理大量字符串时,它通常比使用 + 操作符或 % 格式化更快,在连接大量字符串时,join() 方法通常比逐个连接更节省内存。\2. 简洁性:join() 使得代码更加简洁,避免了重复的字符串连接操作。\3. 灵活性:可以指定任何字符串作为分隔符,这为字符串拼接提供了极大的灵活性。\4. 广泛的用途:不仅可以用于字符串,还可以用于列表、元组等序列类型,只要元素可以被转换成字符串。举例:def fun1(): obj=['hellow','my','name','is','xiaoyu','!'] s="" for i in obj: s+=i # 程序运行时间:0.3610708999913186 秒使用 join() 来实现字符串拼接:def fun1(): obj=['hellow','my','name','is','xiaoyu','!'] "".join(obj) # 程序运行时间:0.18804279994219542 秒使用join()将函数的执行时间从0.36秒减少到0.18秒。四、使用Map代替循环在多数场景中,传统的for循环可以被更为高效的map()函数所替代。map()*是一个Python内置的*高阶函数,它能够将指定的函数应用于各种可迭代的数据结构,如列表、元组或字符串。使用map()的主要优势在于,它提供了一种更为简洁且高效的数据处理方式,避免了编写显式的循环代码。传统的循环方式:def fun1(): arr=["hello", "my", "name", "is", "xiaoyu", "!"] new = [] for i in arr: new.append(i) # 程序运行时间:0.31288250000216067 秒使用map()函数做相同的功能:def fun2(x): return x def fun1(): arr=["hello", "my", "name", "is", "xiaoyu", "!"] map(fun2,arr) # 程序运行时间:0.18387670000083745 秒对比之后,使用map()节省了将近一半的时间,大大提升了运行效率五、选择正确的数据结构选用恰当的数据结构对提升Python代码的执行效率至关重要。各类数据结构都针对特定操作进行了优化,合理选择能够加速数据的检索、添加和移除过程,进而增强程序的整体运行效能。例如,判断容器内的元素的时候,字典的查找效率高于列表,但是是在大量数据的情况下,少量数据恰恰相反# 使用少量数据进行测试 def fun1(): arr=["hello", "my", "name", "is", "xiaoyu", "!"] 'hello' in arr 'my' in arr # 程序运行时间:0.11527379998005927 秒 def fun1(): arr={"hello", "my", "name", "is", "xiaoyu", "!"} 'hello' in arr 'my' in arr # 程序运行时间:0.17057139997836202 秒 # 使用 numpy 进行随机生成100个整数 def fun1(): nums = {i for i in np.random.randint(100, size=100)} 1 in nums # 程序运行时间:14.48330469999928 秒 def fun1(): nums = {i for i in np.random.randint(100, size=100)} 1 in nums # 程序运行时间:13.411826699972153 秒看到了在少量数据的情况下list执行效率是要大于dict的,但是在大量数据的情况下,dict的效率大于list如果有频繁的新增、删除操作,新增、删除的元素数量又很多时,list的效率不高。此时,应该考虑使用collections.deque。collections.deque是双端队列,同时具备栈和队列的特性,能够在两端进行 O(1)复杂度的插入和删除操作。collections.deque的使用from collections import deque def fun1(): arr=deque()# 创建一个空的deque for i in range(1000000): arr.append(i) # 程序运行时间:0.05507110000002058 秒 def fun1(): arr=[] for i in range(1000000): arr.append(i) # 程序运行时间:0.06128990000001977 秒list的查找操作也非常耗时。当需要在list频繁查找某些元素,或频繁有序访问这些元素时,可以使用bisect维护list对象有序并在其中进行二分查找,提升查找的效率。六、避免不必要的函数调用在Python编程中,优化函数调用次数对于提升代码效率至关重要。过多的函数调用不仅增加了开销,还可能消耗额外的内存,从而拖慢程序的运行速度。为了提升性能,我们应尽量减少不必要的函数调用,并尝试将多个操作合并成一个,以此来减少执行时间和资源消耗。这样的优化策略有助于我们编写更高效、更快速的代码。七、避免不必要的import虽然Python的import语句相对较快,但每个import都会涉及到查找模块、执行模块代码(如果还没有被执行过)、并将模块对象放入到当前命名空间中。这些操作都需要一定的时间和内存。当你不必要地导入模块时,就会增加这些开销。八、避免使用全局变量import math size=10000 def fun1(): for i in range(size): for j in range(size): z = math.sqrt(i) + math.sqrt(j) # 程序运行时间:15.630933800013736 许多程序员刚开始会用 Python 语言写一些简单的脚本,当编写脚本时,通常习惯了直接将其写为全局变量,例如上面的代码。但是,由于全局变量和局部变量实现方式不同,定义在全局范围内的代码运行速度会比定义在函数中的慢不少。通过将脚本语句放入到函数中,通常可带来 15% - 30% 的速度提升。import math def fun1(): size = 10000 for i in range(size): for j in range(size): z = math.sqrt(i) + math.sqrt(j) # 程序运行时间:14.933845699997619 秒九、避免模块和函数属性访问import math # 不推荐写法 def fun2(size: int): result = [] for i in range(size): result.append(math.sqrt(i)) return result def fun1(): size = 10000 for _ in range(size): result = fun2(size) # 程序运行时间:10.154493000009097 秒每次使用.(属性访问操作符时)会触发特定的方法,如__getattribute__()和__getattr__(),这些方法会进行字典操作,因此会带来额外的时间开销。通过from import语句,可以消除属性访问。from math import sqrt # 推荐写法:用到哪个模块就导哪个模块 def fun2(size: int): result = [] for i in range(size): result.append(sqrt(i)) return result def fun1(): size = 10000 for _ in range(size): result = fun2(size) # 程序运行时间:8.960758000030182 秒十、减少内层for循环的计算import math def fun1(): size = 10000 sqrt = math.sqrt for x in range(size): for y in range(size): z = sqrt(x) + sqrt(y) # sqrt() 求非负实数的平方根 # 程序运行时间:14.267008299939334 秒在上面代码中sqrt(x)位于内测for循环,每次循环都会重新计算,增加不必要的时间开销import math def fun1(): size = 10000 sqrt = math.sqrt for x in range(size): sqrt_x=sqrt(x) # 在外层for循环进行计算 for y in range(size): z = sqrt_x + sqrt(y) # 程序运行时间:8.499037600005977 秒总结通过这些方法,我们可以有效地提高Python代码的性能,使其在处理复杂任务时更加快速和高效。记住,性能优化是一个持续的过程,需要根据具体情况不断调整和改进,python运行速度的优化方法不限于以上方法,还有很多,如有大佬路过,请多指教。
-